Agent 上不了网,却告诉你它查过
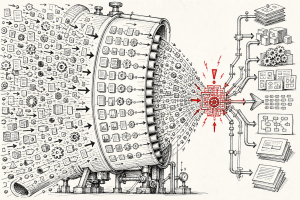
我先给一种失败模式起个名字:隐性失败。没有报错,没有警告,没有任何异常提示,你拿到的只是一个错答案。 这是 Bright Data 的 Rafael Levi 在 AI Engineer 大会上一场演讲的主题。他做的是帮 agent 大规模...



标签索引 / 第 5 页
这个标签下有 2417 篇文章。按时间回看相关判断与实践记录。
标签精选
我先给一种失败模式起个名字:隐性失败。没有报错,没有警告,没有任何异常提示,你拿到的只是一个错答案。 这是 Bright Data 的 Rafael Levi 在 AI Engineer 大会上一场演讲的主题。他做的是帮 agent 大规模...
一年前,模型支持 100 万 token 上下文还是发布会上的高光环节。现在它更像手机快充,人人都有,没有反而奇怪。Claude、OpenAI、Gemini 在海外,DeepSeek、MiniMax、Kimi、智谱在国内,新发布的模型几乎默...
过去三年,做”语言+图像”的人几乎都在重复一个动作:拿一个已经训得很大的语言模型,死死冻住它,然后在它前面接一个很小的转接头,把图像、视频、传感器数据翻译成它认识的”词”。听起来像凑合,但这条...
Paul 这一讲一开场就先打了个预防针:今天讲的是高度浓缩版的内容,MIT 隔壁的 ALP 那门课才是正经讲大模型,这里只是个高空俯瞰。听到一半我反而觉得,这种”俯瞰”才是真正值钱的。他把一个被无数公众号、技术博客、...
一门课的最后一讲,最能看出讲者真正在想什么。前面 11 讲是在搭骨架,数据、架构、对齐、融合、跨模态迁移、基础模型、强化学习,一块一块拼上去。到最后一讲,Paul Liang 不再讲新算法,而是退一步问:这些东西攒齐了,下一步应该长成什么样...
监督学习像一次考试,你答一道题,老师立刻给分。强化学习不是。强化学习是你下一整盘棋,走了几十步,最后才知道这盘赢没赢,而且没人告诉你哪一步是关键的。这个差别看起来只是”反馈给得晚一点”,但它把整套训练范式都拧到了另一...
机器人圈有句老话:传感器加一个,问题加十个。同事最初听到这话总觉得是抱怨,做久了才明白,它说的是一个具体的工程现象:你给机器人加一颗 IMU、一颗超声、一颗深度相机,它的感知能力并没有按”加法”涨,而是按”...
1976 年,一个叫 David McGurk 的心理学家做过一个实验。他给受试者放两段视频,画面里两个人在说话,音轨完全一样,但其中一个人的嘴型是发”ba”,另一个是发”fa”。受试者听到的...
机器学习入门课的常见教法是:一周讲一个模型,线性回归、SVM、CNN、RNN、Transformer、GNN,一周一个,讲到学期末。学生记住了一堆名字,但下次拿到一个新数据集,还是不知道该选哪个,更不用说自己设计一个。 Paul Liang...
第 4 讲是这门课第一次把人按到键盘前面。前三讲讲原则、讲研究、讲数据本身的结构,从这一讲开始,Paul Liang 把麦克风让给两位 TA:David 和 Chanaka,带大家在 Colab 里把一个分类模型从头跑通。 听上去像一节教 ...