


PentAGI 把渗透测试从「人拿工具逐条试」变成「智能体自己拆任务、跑工具、串路径」,防御侧要面对的不再是单点漏洞,而是被自动组合出来的攻击链。一次针对自有服务的扫描报告里,15 条发现有 6 条属于组合利用——这个比例比工具本身更值得看。
事实口径:PentAGI 官方中文站与架构、Agents、Memory 三份概念文档,核对日 2026-11-12;15 条发现来自一份自有服务的扫描报告摘要,只保留分类与条数,不含目标信息、资产清单与漏洞明细。第三方来源用于交叉核对,不同时间点的数字不合并计算。


15 条发现里,最扎眼的不是漏洞数量
报告打印出来只有三种分类:访问控制缺陷(越权/提权)、攻击链(组合利用)、注入。15 条发现里,前两类占了 13 条。这个分布和很多人对「被黑」的想象不一样——不是某个高危漏洞一击致命,而是权限边界到处漏,再被一条条串起来。为了不把个案写成通用规律,下面只讨论这 15 条的分类构成,不涉及目标、资产和具体漏洞细节。
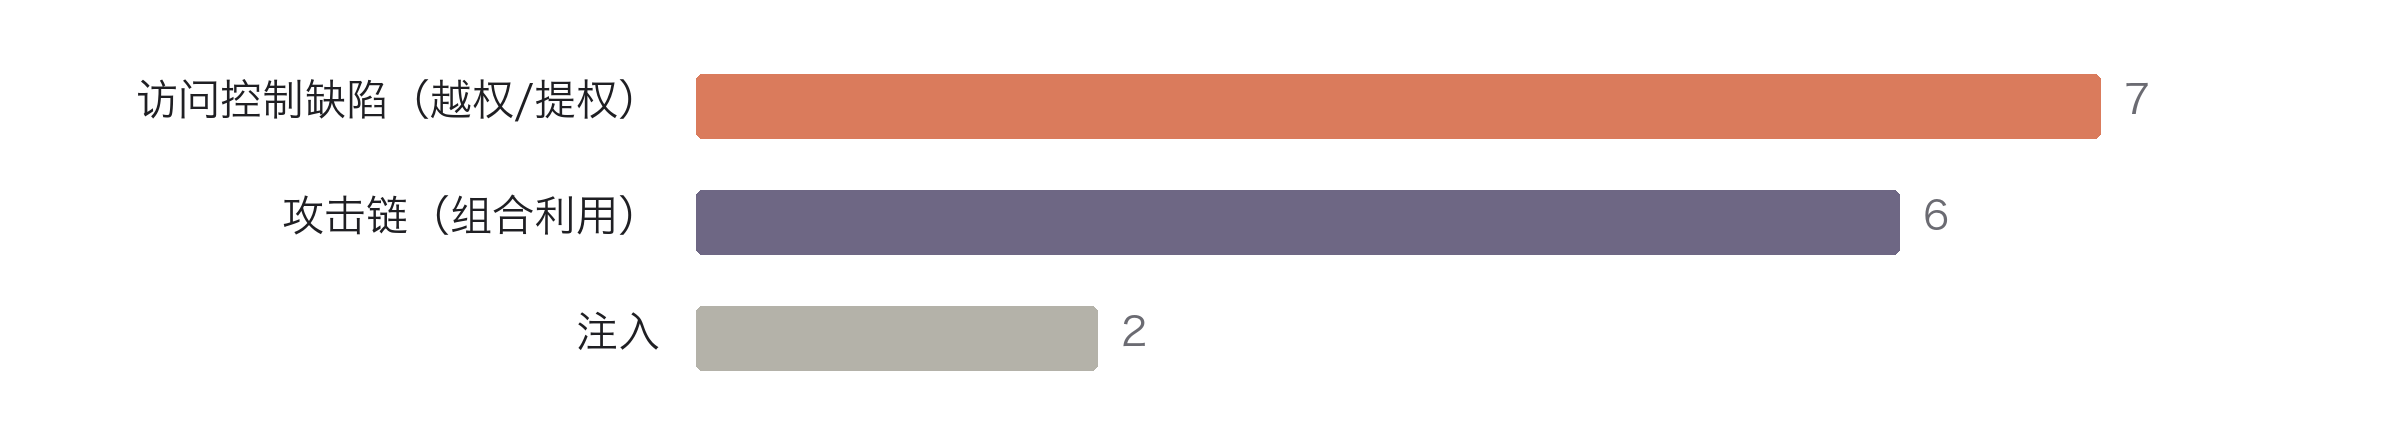
一份自有服务扫描报告的 15 条发现分类:访问控制缺陷 7 条、攻击链 6 条、注入 2 条,前两类合计 13 条。
7 条越权/提权是最大的一块。这类问题的共同点是:功能本身没写错,错在「谁能调它」没被约束住。它不像注入那样能靠参数过滤一次性收敛,往往散落在多个接口、多个角色、多个状态里,修完一个还会从另一个冒出来。
6 条攻击链更值得停下来看。单独拎出其中任意一环,可能只算「低危信息泄露」或「配置不当」,评级时容易被排到后面;但把它们按顺序接起来,结果就是完整的权限接管。传统漏洞管理按条立项、按单个评分排优先级,天然看不见这种「每条都不算严重、连起来很严重」的问题。
2 条注入反而是最少的一类。这不是说注入消失了,而是经过十几年框架默认转义、参数绑定和边界防护的普及,它已经不是最容易得手的那条路。真正还敞开的是业务权限和组合路径——恰好是规则型扫描器最难自动判断、而智能体最擅长反复试探的部分。
注意:「攻击链」说人话就是:A 处能读到一份不该读的配置,B 处能用这份配置换到一个低权限令牌,C 处这个令牌恰好能改另一个角色的权限。三处单独报都像小毛病,连起来就是提权。
PentAGI 解决的是哪一段人力
渗透测试的成本结构长期是倒挂的:真正需要经验和直觉的判断只占很小一段,剩下大量时间花在侦察、枚举、版本比对、把工具 A 的输出喂给工具 B、把结果抄进报告。这些活重复、有固定套路、又必须一步步记着前面发生了什么——正好是自主智能体最适合的形状。
PentAGI 的定位就落在这里:使用者用自然语言写一句目标和范围,剩下的规划、检索、执行、汇总交给一组智能体。官方的说法是「描述目标和目的,PentAGI 规划工作,在隔离沙箱中运行工具,从每一步中学习并报告发现项」。它不是新造了什么攻击工具,nmap、Metasploit、sqlmap 都是几十年的老东西;它造的是把这些工具串起来的那一层。
为什么非要拆成一堆智能体,而不是让一个模型从头跑到尾?答案在长任务上:单个模型同时负责侦察、规划、写利用代码和执行,上下文很快被工具输出淹没,三步之前扫到了什么端口、哪个服务版本对得上哪个公开漏洞编号,转头就忘。拆开角色之后,每种智能体有自己的提示词、模型配置和工具集,上下文只装自己那部分。这个理由对所有长链路 Agent 系统都成立,不止安全领域。
核对日可确认的几个量级
| 指标 | 数值 | 说明 |
|---|---|---|
| 智能体类型 | 13 + 2 | 官方文档列出 13 种 agent 类型,另有 memorist、reporter 两个后台常驻 |
| 内置安全工具 | 20+ | nmap、Metasploit、sqlmap 等,全部在独立容器运行 |
| 内置模型提供商 | 12 家 | 另支持任何 OpenAI 兼容端点作为自定义提供商 |
| 最低部署资源 | 2 vCPU / 4 GB / 25 GB | Docker Compose,另需至少一个模型提供商 |
| 开源协议与版本 | MIT / v2.2.0 | 自托管,v2.2.0 发布于 2026-10-05 |
先把它翻译成你熟悉的系统
第一次看多智能体渗透测试平台,很容易被一堆新名词挡住。其实把名字划掉,底下就是一套标准的 Agent 运行时:有编排、有工具执行沙箱、有记忆、有状态机、有护栏、有可观测性。下面这张表把 PentAGI 的组件对到做业务系统时已经见过的东西,看完再回去看架构会快很多。
| PentAGI 里的组件 | 对应你做过的东西 | 在系统的哪一层 | 解决什么问题 |
|---|---|---|---|
| generator / refiner / adviser 规划链 | LangGraph 的 DAG 与条件边 | 编排层 | 把一句目标拆成可执行的子任务,并按结果回改计划 |
| primary_agent 与专业智能体分工 | Agent 运行时的角色与专属提示词 | 运行时层 | 避免单模型长任务丢上下文,每个角色只装自己的上下文 |
| PostgreSQL + pgvector 长期记忆 | RAG 的向量检索与上下文装配 | 记忆层 | 让智能体执行前先查「以前遇到过类似的吗」 |
| 工作记忆 / 情景记忆 / 知识图谱 | 会话状态 + 事件流水 + 实体关系库 | 状态层 | 记住当前目标、任务状态与历史动作,跨任务沉淀主机与服务关系 |
| 每个流程独立的 Kali 沙箱容器 | 容器化执行 / K3s 的隔离 Pod | 执行层 | 工具绝不落在宿主机,生产可迁到独立工作节点 |
| 轮次上限、重复检测、reflector | Stop hook 与状态机里的护栏 | 控制层 | 模型卡住或开始空转时强制停下来,别无限烧额度 |
| REST + GraphQL + 令牌鉴权 | 自有后端对外的接口层 | 接入层 | 从持续集成或内部平台触发一次测试,不用点界面 |
| Grafana / Jaeger / Langfuse / OTel | 服务可观测性栈 + 链路追踪 | 观测层 | 事后能逐条回放智能体为什么做了那个决定 |
名称陌生,位置不陌生:PentAGI 是把 Agent 平台的既有零件搬到了攻防场景。
这张表想说明的是:PentAGI 在架构上没有发明新范式,它是把 Agent 平台这几年攒出来的那套零件,第一次完整地搬到了攻防场景里。真正的差别在目标函数——业务 Agent 追求「把事办成」,攻防 Agent 追求「找到一条能走通的路径」,后者天然会去试探边界、组合异常,对护栏的要求高一个量级。
整体架构:四组服务,加一条绝不碰主机的边界
按官方架构文档,PentAGI 是一组 Docker 服务,按用途分四组。核心组足够跑完整流程,其余三组都是可选项,用附加的 Compose 文件叠加。
| 服务组 | 包含的服务 | Compose 文件 | 是否必需 |
|---|---|---|---|
| 核心 | pentagi(Go 后端 + React UI)、pgvector、pgexporter、scraper | docker-compose.yml | 必需 |
| 知识图谱 | graphiti、neo4j | docker-compose-graphiti.yml | 可选,默认关闭 |
| 模型可观测性 | langfuse-web、langfuse-worker、clickhouse、redis、minio、postgres | docker-compose-langfuse.yml | 可选 |
| 系统可观测性 | grafana、otel、victoriametrics、jaeger、clickstore、loki、node-exporter、cadvisor | docker-compose-observability.yml | 可选 |
服务分组来自官方架构文档;核心组之外的三套都是叠加层,不是启动前提。
后端是 Go,对外同时给 REST 和 GraphQL,带令牌鉴权供自动化调用;前端是 React、TypeScript 加 Vite;数据落在带 pgvector 扩展的 PostgreSQL 里,每条命令和它的输出都被存下来并做成向量。工具永远不会在 pentagi 这个容器内部执行——每个流程会拿到一个按目标挑选镜像(通常是 Kali Linux)的独立沙箱容器,生产环境官方建议把沙箱挪到单独的加固工作节点上。这条边界是整个项目最要紧的设计:让模型拿到终端,又不让它碰到宿主。
知识图谱是可选叠加层,开起来之后智能体的回答和工具执行会送到 Neo4j 上的 Graphiti,按摄取规则抽出主机、服务、漏洞、技术这些实体和它们随时间的演变关系。它默认关闭,而且官方明确写了 Graphiti 自带接口没有鉴权,必须和 Neo4j 一起放进私有网络——这种细节比功能列表更能说明项目的工程成熟度。
流程数据模型示意
Flow(一次测试)
 └── Task
      └── Subtask
           └── Action ──> 独立沙箱容器
                ├── 命令 + 输出 ──> PostgreSQL / pgvector
                └── 实体 + 关系 ──> Graphiti / Neo4j(可选)
Flow → Task → Subtask → Action 这四层是它的数据模型骨架。所有东西都挂在叶子节点上:命令、输出、产物、记忆。看着普通,恰恰是这层让「三步之前扫到了什么」变成一次可查询的检索,而不是靠模型自己记。
组件职责:15 个智能体各自干什么
官方文档列了 13 种 agent 类型,另有 memorist 和 reporter 两个后台常驻,合计 15 个。按职责分五组更清楚:
| 分组 | 智能体 | 职责 |
|---|---|---|
| 驱动与交互 | primary_agent、assistant | 主推理链;交互式助手模式,与自主流程共用同一套工具 |
| 规划 | generator、refiner、adviser | 拆子任务、按返回结果修订计划、给专家建议;在监控里兼导师,在任务规划里兼规划师 |
| 信息与记忆 | searcher、enricher、memorist | 联网与漏洞库检索;回答前从记忆和沙箱补上下文;基于长期记忆回答其他智能体的追问 |
| 执行 | pentester、coder、installer | 安全评估与利用;写与分析代码;在沙箱里装工具、配环境 |
| 纠偏与产出 | reflector、reporter、simple、simple_json | 把只回散文、不调工具的模型拉回工具调用;写每个任务的结果报告;纯文本与结构化补全 |
按官方 Agents 文档的角色清单归组;13 种类型加 2 个后台常驻智能体。
分工的关键不在角色多,而在每个角色能单独配模型。官网明确说可以为不同角色选更强或更便宜的模型——规划和执行用前沿模型,检索、补全、格式化用便宜模型甚至本地小模型。这在成本上是很实际的一刀,也让「任意模型」这句宣传落到了可执行的位置:内置 12 家提供商,另外任何 OpenAI 兼容端点(vLLM、LiteLLM、OpenRouter 等)都能作为自定义提供商接进来。2.2.0 还加了提供商故障转移,失败的模型调用会在备用提供商上重试,切换过程写进链路追踪。
执行流程:一句自然语言到一份报告
官网把流程写成五步:目标、规划、研究、执行、报告。展开是这样:
| 阶段 | 谁在做 | 实际动作 |
|---|---|---|
| 目标 | 使用者 | 用自然语言写清目标和测试范围,划定能做什么、不能做什么 |
| 规划 | generator / refiner / adviser | 把任务拆成子任务,按返回修订计划;开启智能规划时先拟 3–7 个具体步骤 |
| 研究 | searcher / memorist / enricher | 从网络和漏洞库收最新上下文,回看流程里已发现的内容,补齐执行前的信息 |
| 执行 | pentester / coder / installer | 在带 Kali 工具集的隔离容器里跑命令、写利用代码、装依赖 |
| 报告 | reporter | 逐任务汇总,整条流程可导出 Markdown 或 PDF |
支撑这条链的是三层记忆:长期记忆放在带 pgvector 的 PostgreSQL 里,存结果、成功方法和工具知识的向量;工作记忆放在流程上下文里,存当前目标、任务状态和可用资源;情景记忆就是命令历史,存过往操作和有效模式。智能体每次动手前会先查向量库找相似案例,再把发现写回去。另有链式摘要,让长流程不撑爆上下文窗口;可选的 Graphiti 知识图谱负责把主机、服务、漏洞之间的关联记成图。
这里有个容易被忽略的工程判断:渗透测试的难点从来不是跑 nmap,而是记住 nmap 三个子任务之前说了什么、据此决定下一步、并且不重复自己。PentAGI 把「记忆」当一等公民而不是附加功能,这是它和普通「让模型调几个工具」的脚本最实质的区别。
护栏:让它停下来比让它跑起来更难
让智能体自主调用攻击工具,最怕的不是它不够聪明,是它卡住之后无限循环、把额度和时间烧光。官方单独写了一节安全防护,五道机制里前三道始终开启:
| 机制 | 触发条件 | 动作 | 默认状态 |
|---|---|---|---|
| 轮次上限 | 主智能体 100 轮,其他智能体 20 轮 | 到达上限停止模型链 | 始终开启,可改默认值 |
| 重复检测 | 从第 3 次连续同参数调用同一工具开始 | 不再执行该工具,返回上次结果并要求换方向;第 7 次终止该链 | 始终开启 |
| reflector | 模型不发起工具调用、直接回散文 | 引导重新使用工具;连续 3 轮仍失败则停止该链 | 始终开启 |
| 执行监控 | 连续 5 次调同一工具,或距上次建议已 10 次工具调用 | adviser 以导师身份审查进展,建议继续、换方法或停止 | 测试版,默认关闭 |
| 智能任务规划 | 专业智能体开始子任务前 | adviser 预先拟 3–7 个具体步骤 | 测试版,默认关闭 |
阈值来自官方 Agents 文档的「安全保护机制」一节;执行监控与智能任务规划在 Enterprise 中默认开启且阈值更高。
最有意思的是官方文档对后两项给出的代价:对参数量低于 32B 的模型,同时打开执行监控和任务规划,结果质量大致翻倍,代价是 Token 消耗和时间增加 2–3 倍。所以默认关着。这句话比任何跑分都诚实——它等于承认「小模型会走丢」,也承认监督机制不是免费午餐,是用算力和时延换完成率。
这套东西的价值不限于安全工具。任何把工具调用权交给模型的系统,都会遇到同样的三件事:重复调用、只说不做、上下文漂移。轮次上限、重复检测、把模型拉回工具调用,是可以直接搬进自家 Agent 运行时的三条通用护栏。区别只在于,PentAGI 手里握的是 Metasploit,护栏失效的后果比多花点额度严重得多。
背景:官方把工具隔离写成了硬边界:终端命令和文件操作只跑在流程自己的容器里,绝不跑在 PentAGI 容器内。生产环境建议把沙箱迁到独立工作节点。这是「给模型终端」这件事能做的前提。
社会性风险:门槛、速度,还有治理缺口
回到开头那份报告。AI 让攻击侧变强,不是因为它发明了新漏洞,而是因为它把三件原本稀缺的东西变便宜了。
第一是经验门槛。过去要串出一条攻击链,得有人知道该先扫什么、哪个版本对哪个公开漏洞、拿到低权限之后往哪横向走;现在这些判断被拆进提示词、工具集和向量记忆里,使用者只需要写一句目标和范围。第二是时间。人做一轮完整侦察加验证以天计,机器以小时计,而且可以多流程并行跑同一个目标。第三是累积。三层记忆加跨流程知识库,意味着一次测试学到的东西下次能直接复用,能力随使用次数增长,不是每次从零开始。
这三点叠在一起,防守侧的成本结构就变了:防守必须每次都对,攻击只要对一次。而像 PentAGI 这样的工具是 MIT 协议、完全自托管、公开可下载,官方只能靠使用条款把「必须获得明确授权」写成合同义务,技术上没有任何东西能阻止有人拿它去扫不属于自己的系统。
扩散速度有公开数字,但口径必须说清
项目热度有公开数字,很容易被写成一条看着很顺的增长曲线。下面把它们按来源和时间点摊开,而不是连成曲线:
| 来源 | 时间点 | Star 数 | 口径说明 |
|---|---|---|---|
| VXControl 公司站 | 2025-11 | 801 | 公司站「过去 12 个月增长」给出的起点 |
| The Agent Times 报道 | 2026-03 | 12,000+ | 第三方报道,开源后数周,非官方计数 |
| DEV.co 仓库快照 | 2026 年中 | 18,500 | 页面标注最后更新 2026-07-03、版本 v2.1.0,属旧快照 |
| VXControl 公司站 | 2026-10 | 32,300+ | 公司站另一个时间点的表述 |
| PentAGI 官网中文页 | 2026-11 | 34,000 | 官网写「3.4 万」,公司站同期写 33.4k+ |
不同主体、不同抓取时点,连官方自己的两处表述都不是同一个数,不能拼成精确曲线。
这些数字不能相加、不能求增长率,能确认的只有量级:一年之内从三位数涨到万级。对防守方来说,量级就够了——它说明这套能力已经不是少数团队的专属。
双刃剑的另一面也真实存在:没有专职安全团队的中小团队,第一次有了能在自己的基础设施上跑完整红队流程的东西;REST 和 GraphQL 接口可以挂进持续集成,把安全回归做成常规动作;全链路追踪让每一步决策可回放。工具本身不分攻守,分的是谁先把它用起来、以及用的时候有没有授权。
把结论收回到那份 15 条的报告上:优先级不该按「哪条漏洞评分高」来排,而该按「哪几处权限边界能被串起来」来排。7 条越权是面,6 条攻击链是线,2 条注入是点。先把面和线补上,比继续加一层参数过滤更划算。另外,如果自家系统里也已经跑着带工具调用权限的 Agent,它同样该被放进这个威胁模型——它就是一个有终端、有记忆、可能被诱导去试探边界的新入口。
注意:授权边界不是免责声明。官方使用条款把「仅测试自己拥有或明确获授权的系统」写成合同义务,网站首页也直接放了这句。拿它去扫别人的服务,既违法也不是本文讨论的用法。
引用与来源
- PentAGI 官网中文页 — 产品定位、五步流程、版本与部署要求,核对日 2026-11-12
- 官方文档 · 架构 — 四组服务、容器边界、数据层
- 官方文档 · Agents — 智能体类型清单与安全保护机制阈值
- 官方文档 · Memory 与知识 — 三层记忆与可选知识图谱
- VXControl 公司站 — 技术栈与 Star 口径
- GitHub 仓库 vxcontrol/pentagi — MIT 协议与版本发布
- Heatdrop 项目分析 — 监督机制的工程解读,第三方观点
- DEV.co 仓库快照 — 旧版本与旧计数,仅作口径对照
- The Agent Times 报道 — 2026-03 扩散情况与双刃剑讨论,第三方报道


