Pablo Castro 把 agent 的知识拆成三类
Pablo Castro 来自 Microsoft,是 CVP 和 Distinguished Engineer。他这场 “On AI and Knowledge” 很适合作为第一天的开篇,因为 software f...



标签索引 / 第 4 页
这个标签下有 2415 篇文章。按时间回看相关判断与实践记录。
标签精选
Pablo Castro 来自 Microsoft,是 CVP 和 Distinguished Engineer。他这场 “On AI and Knowledge” 很适合作为第一天的开篇,因为 software f...
作者:toy | 覆盖周期:2026.06.20 – 2026.06.26 这一周,OpenAI 有三件事砸在同一个窗口里:6 月 24 日和博通一起亮出第一颗自研芯片 Jalapeño,6 月 25 日被白宫要求把新模型 GPT-5.6 ...
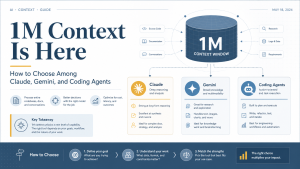
有人在搜索框里反复打”1m 上下文已经全量可用”。这背后不是想读一篇科普,而是一个很具体的工程疑问:我现在用的模型,到底是不是已经能吃下 100 万 token 的上下文?如果能,我该不该把整个仓库、整本手册、整批日...
豆包是字节跳动的 AI 助手,2024 年 5 月上线,背后是 Doubao-Seed 系列大模型。它在国内是装机量最大的 AI 应用之一,但「好用」和「值不值得你用」是两件事。 我把豆包当主力工具用了一段时间,也拿同样的任务喂给 Chat...
本地大模型怎么选:Qwen3.6 27B BF16 与 Step3.7 IQ4_XS 横评,从量化精度、显存账、编码 benchmark、Agent 适配、推理速度五个维度给一张选型矩阵,附四类使用者落地建议。
作者:toy | 覆盖周期:2026.06.13 – 06.19 卷首语 本周是 2026 年第一次能清楚看到”治理变量”压过”模型变量”的一周。 周一晚 OpenAI 被 42 个州的检察长...
我最近看了 Austin Marchese 解读 Karpathy 在 AISN 2026 上的发言,被里面一个反常识的小例子卡住了:你问 AI “我去 50 米外的洗车店该开车还是走路”,Claude、Gemini...
有个概念我最近一直在用,叫”聪明区”和”笨蛋区”。提出它的是 Human Layer 的 Dex Hardy:一个大模型刚开始一段新对话时最聪明,因为这时注意力关系最松弛;你每往上下文里塞一个...
我先给一种失败模式起个名字:隐性失败。没有报错,没有警告,没有任何异常提示,你拿到的只是一个错答案。 这是 Bright Data 的 Rafael Levi 在 AI Engineer 大会上一场演讲的主题。他做的是帮 agent 大规模...
一年前,模型支持 100 万 token 上下文还是发布会上的高光环节。现在它更像手机快充,人人都有,没有反而奇怪。Claude、OpenAI、Gemini 在海外,DeepSeek、MiniMax、Kimi、智谱在国内,新发布的模型几乎默...