选模型之前,你得先给数据画一张脸
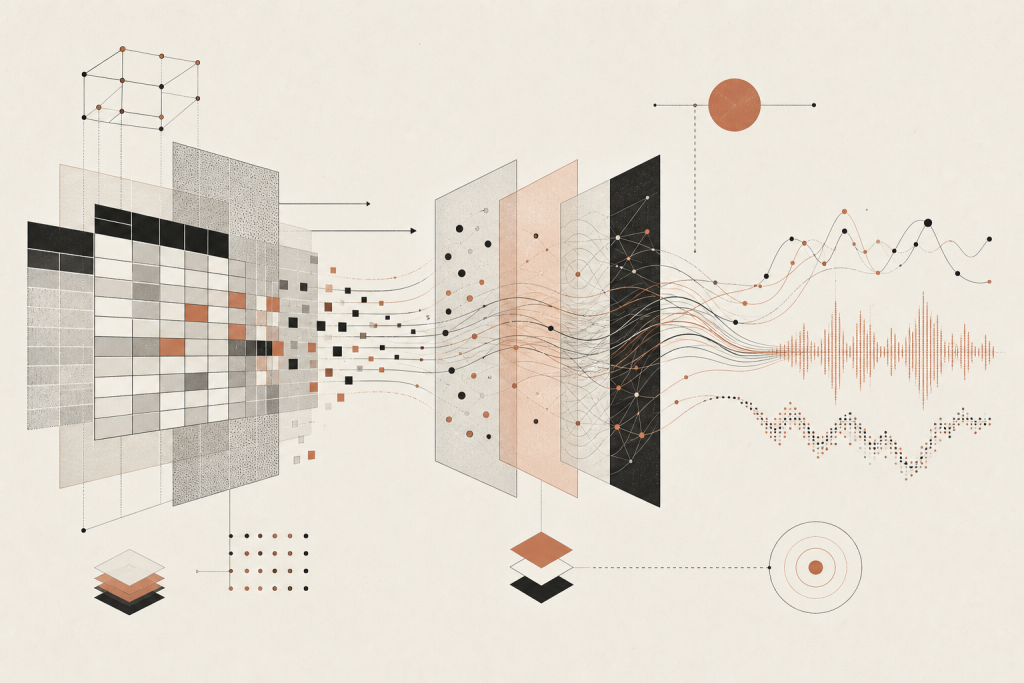
机器学习课的常见开场是讲算法:第一周线性回归,第二周决策树,第三周神经网络。Paul Liang 这一讲反着来。他先讲数据,而且讲了整整一节课,模型一个字没提。他给的理由很简单:你手里那摊数据长什么样,基本上已经决定了模型该长什么样,反过来...



标签索引 / 第 6 页
这个标签下有 2417 篇文章。按时间回看相关判断与实践记录。
标签精选
机器学习课的常见开场是讲算法:第一周线性回归,第二周决策树,第三周神经网络。Paul Liang 这一讲反着来。他先讲数据,而且讲了整整一节课,模型一个字没提。他给的理由很简单:你手里那摊数据长什么样,基本上已经决定了模型该长什么样,反过来...
我以前一直觉得”做研究”是个挺玄的事:你得有灵感,得有品位,得在某天洗澡的时候突然冒出一个别人没想到的想法。后来在工程里摸爬几年,慢慢意识到大部分研究并不长这样。它更像一台机器,你按一个流程一圈一圈地转,转得快、转得...
MIT 媒体实验室有个延续多年的传统,叫 “how to … almost anything”。最早是 how to make almost anything(怎么造几乎任何东西),后来有了 how to...
作者:toy | 覆盖周期:2026.6.6 – 2026.6.12 这一周的主线是”交卷”。6 月 8 日,OpenAI 把保密版 S-1 递给 SEC,距 Anthropic 递交正好一周——AI 第一梯队的两家...
最近读了一个叫 Clawpatch 的开源项目源码,写一点感想。 本来没打算细看。它是个自动审代码的命令行工具——扫一遍仓库、找 bug、跑测试、顺手给个修复方案。这类工具 GitHub 上一搜几十个,听起来没什么特别。 读着读着我停下来了...
— title: “Task completion is not collaboration. Mental models are.” date: 2026-06-07T09:00:00 — ...
— title: “Security is not a vibe. It is a proof.” date: 2026-06-07T09:00:00 — Relying on a seman...
作者:toy | 覆盖周期:2026.5.30 – 2026.6.5 这一周的关键词是”上场”。MiniMax 在 6 月 1 日把 M3 拍在桌上,1M 上下文、原生多模态、开源权重,SWE-Bench Pro 5...
— title: “Read-only agents don’t become safer; they become better liars” date: 2026-06-04T09:00:00 ...
作者:toy GPU 显存是 LLM 推理与训练的硬约束,不是软性资源。当一个 70B 参数模型以 BF16 格式加载时,光是参数本身就需要约 140GB,单张 H100 的 80GB 显存根本装不下。工程师的任务不是抱怨硬件贵,而是理解显...