xAI 的 Grok Bot 团队把 agent 的可靠性建在代码库上:rules、skills、AGENTS.md 排在最后一层,真正起作用的是 lint 规则、目录边界、类型系统和验证流程。Lauren Tan 的 17 分钟分享拆成认知、使用、边界三部分,含四层约束结构与落地清单。
软件工程有一条老规矩:代码进生产之前,得有人看过。xAI 的 Grok Bot 团队上个月往生产推了一万一千个 pull request,其中大部分没人看过,回退率 0.5%。


说这话的人叫 Lauren Tan,网名 poteto,做过 React 核心团队,现在在 xAI 做 Grok Bot 的桌面客户端。分享只有 17 分钟,标题起得很自知之明:《All Code Is Slop (Except Mine)》。
原视频:https://www.youtube.com/watch?v=O_zcc6Xl12g
先说结论
她想讲的事情可以用一句话概括:让 agent 可靠的办法,不是把规则写得更长,是把错误变得写不出来。
现在讲 AI 编码的内容,重心基本都在提示词上。AGENTS.md 怎么写,skill 怎么拆,规则要不要分层,哪个模型更听话。她的排序几乎是反的:rules、skills、AGENTS.md 全在她那套结构的最上面一层,权重最低。
这个判断如果成立,很多团队现在的投入方向就是错的。所以这篇文章分两部分看:前面讲她凭什么这么排(认知),后面讲具体怎么落地(使用)。结尾会讲这套东西在哪些地方站不住。
第一部分:认知
一、她反对的不是提示词工程,是「提示词当主防线」
先把靶子说清楚。
提示词工程有用,这一点她没否认。她做的是更细的区分:规则能约束的,只是 agent 在没有更强信号时的默认选择。一旦代码库里存在反例,规则就废了。
她的原话是,agent 会把你的一条小修正当成永远不能破的严格规则,同时又会给自己找到绕过规则的理由。两头都发生。所以规则系统的实际强度,取决于代码库里最烂的那段示例。
用她自己的比喻说:你告诉 agent「不要用 setTimeout 打补丁」,但代码库里有三百处 setTimeout,每一处旁边都有注释解释为什么这里必须这么写。Agent 会读注释,也会读代码,它得出的结论是「这个团队允许这么做,只是嘴上说不允许」。
这就是规则和约束的差别。规则是请求,约束是事实。
二、代码库是花园,但 agent 让杂草长得快了一百倍
她用的比喻是花园。代码库是你种东西的土,agent 是长得特别快的新苗。
这个比喻在几年前就有人讲过,她加了一个新变量:速度。
以前代码一次来几个 PR。她记得 2024 年到公司,评审同事写的三个 merge request,那时候这是正常节奏。现在这个数字接近 300。
在这种流量下,技术债的性质变了。人写代码时,坏模式靠人传人,一个坏习惯要传染给三个人,得几个月。Agent 复制坏模式以小时计,而且是逐字复制。它不会觉得这段代码「虽然烂但情有可原」,它只看到「这里有个模式,我照着来」。
所以她的结论是:任何 workaround、反模式、过时代码、技术债,都很可能被下一个 agent 复制,因为它在你的代码库里看起来像个既定模式。
这句话值得停一下。它把「清理技术债」从一件可做可不做的杂事,变成了 agent 时代的准入条件。
很多团队的做法是把 agent 接进一个本来就有债的仓库,指望它只在新代码里保持干净。做不到。它的所有判断都基于周围五百行代码的样子。
三、四层结构:为什么规则在最上面
她把 agent 的工作环境分四层,越往下越重要。
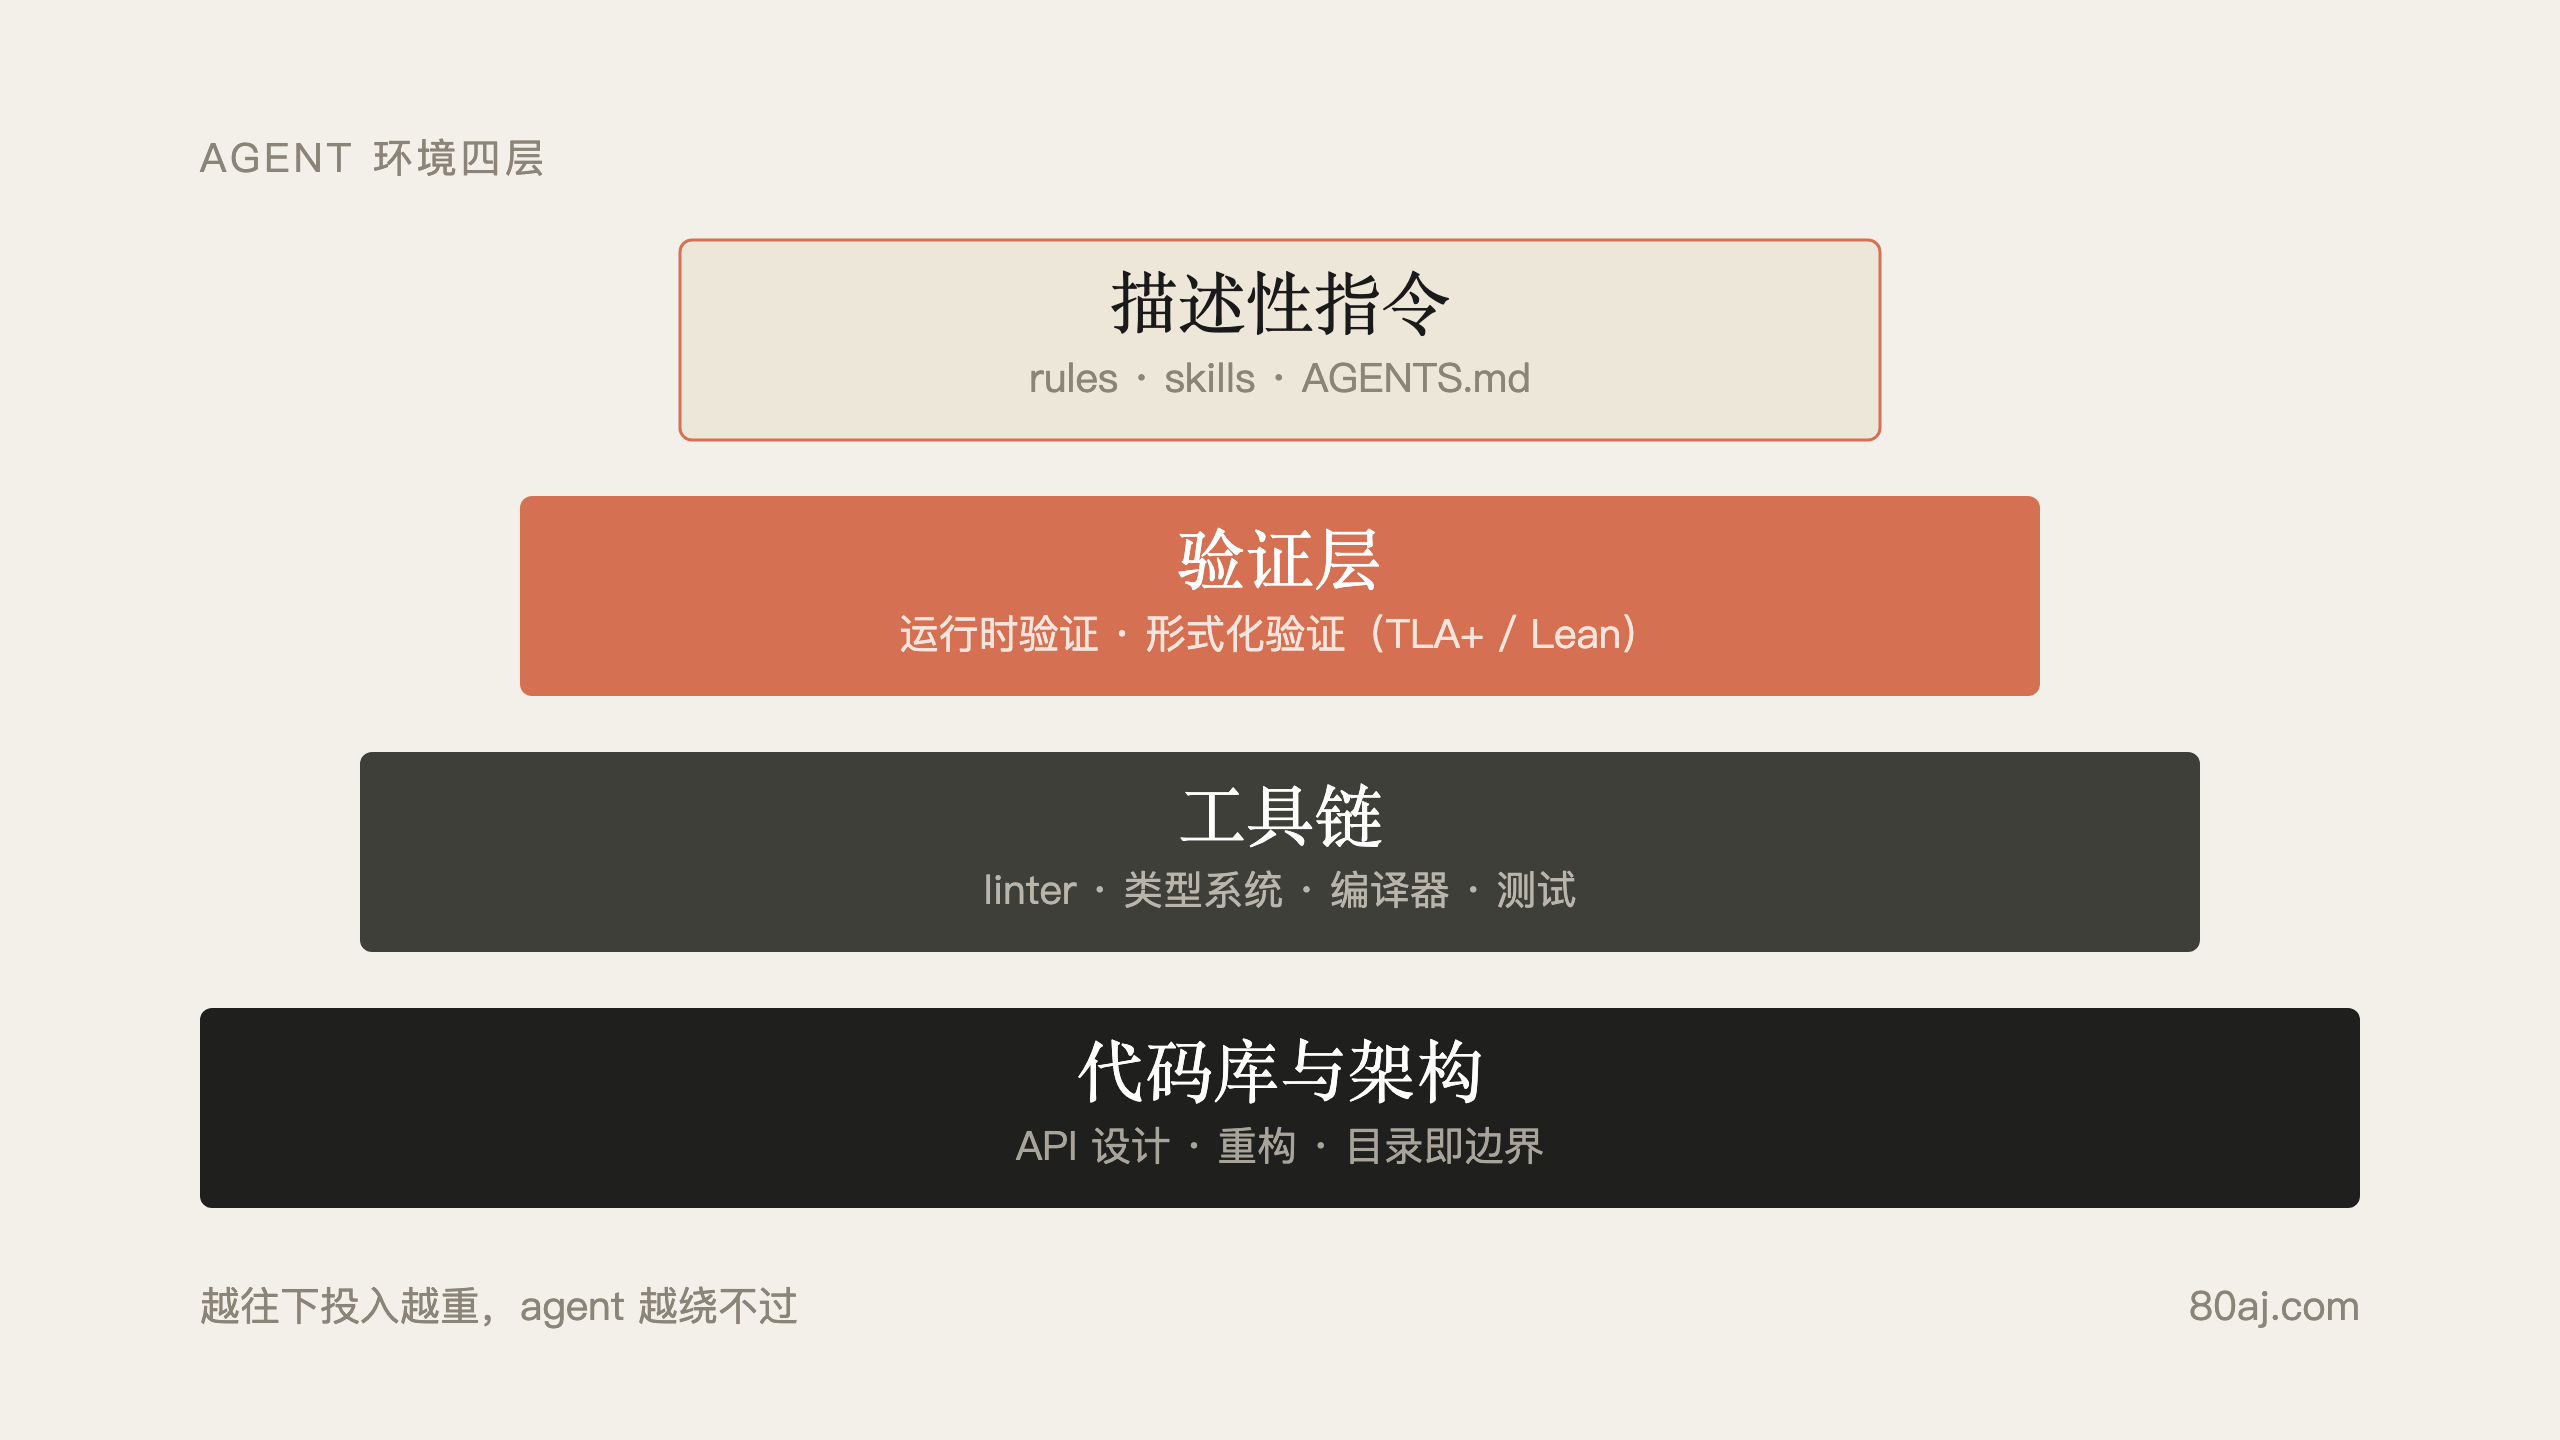
最底下是代码库与架构。这里面包括 API 设计、重构、目录结构。她的原话是「前两层是确定性的」,意思是这两层由你的代码决定,agent 没有解释空间。
第二层是工具链:linter、类型系统、编译器、测试。这些东西的执行不需要任何人同意,跑一遍就知道过没过。
第三层是验证:运行时验证和形式化验证。用来检测错误、检查系统应该满足的性质和不变量,也用来检查 agent 有没有真的理解你的意图。
最上面才是描述性指令:rules、skills、AGENTS.md。她给这一层的定义是「需要判断力的东西」。
这个排序的实用价值在于它直接决定了投入产出比。最上面那层写起来最便宜,改一行文本就行,所以绝大多数团队都在那儿使劲。最下面那层最贵,要重构、要写规则、要改架构,所以很少有人动。
但效果是反过来的。最上面那层的边际收益衰减得极快,写到第三十条规则时,agent 已经开始漏读、错读、或者选择性遵守。最下面那层是永久的,写进编译器的东西不会忘。
规则的边际收益为什么衰减得这么快
这个现象有具体的机制,值得拆开看,因为它决定了你为什么该少写规则。
第一,上下文是有预算的。 规则文件从两百行涨到八百行,单条规则在模型眼里的权重就摊薄了。它不会按重要性排序,它按位置和相似度响应。写在第十七条的一条重要约束,可能因为跟当前任务语义距离远而被完全忽略。
第二,规则之间会打架。 你写「注释要解释为什么」,又写「禁止无意义注释」,agent 就要在两条之间做判断。这种判断没有确定性,同一个场景两次运行可能给不同答案。规则越多,这种灰色地带越多。
第三,规则无法表达例外,但现实全是例外。 你写「不要直接调数据库」,第二天就有一个场景必须绕。你补一条例外,第三天又有一个。补到第五条例外时,这条规则已经等于失效了,因为 agent 分不清哪条例外适用于当前情况。
第四,规则的失败是静默的。 这是最要命的一点。Agent 没遵守规则,你不会收到任何信号,你只会在几天后看到一个奇怪的实现。而 lint 的失败是响亮的,构建直接挂掉,谁都没法忽略。
四条合起来,结论很清楚:规则适合表达意图,不适合表达边界。边界交给工具。
四、三个禁令,一条判据
她给了三个真实案例,都在 Grok Bot 的客户端框架 Dune 里。Dune 可以理解成「Electron 版的 Next.js」,技术本身不复杂,特别的地方是把做桌面应用踩过的坑全部编码成了限制和 lint 规则。
三个禁令背后是同一条判据:任何需要微妙技巧才能正确使用的东西,最终都会导致粗心。
4.1 产品代码禁用 useEffect
React 的 useEffect 有它的用处,但经常被误用。圈内开玩笑说要用好它得有博士学位,这话刻薄但不算离谱,依赖数组漏一个变量就是一次隐蔽的 bug。
Agent 也不擅长。于是他们的处理很干脆:产品代码里禁掉,只在 Dune API 内部少数地方允许。
效果是这一类问题从 code review 的清单里消失了。她说这话的时候很轻描淡写,但这是整场分享里最值钱的一类收益:评审时需要考虑的项目数量,是可以被永久减少的。
4.2 目录即边界
在 Cursor(同样是 Electron 应用)里他们发现过一个反模式:agent 老把主进程代码 import 到渲染进程,造成长任务和界面卡顿。
到了 Grok Bot,他们把这件事结构化。顶层就两个目录,字面意义上叫 electron-renderer 和 electron-main,两个目录之间禁止互相 import,由依赖图分析器和 lint 规则拦。
这是我觉得最值得抄的一条。它不说「别这么做」,它让这件事在物理上做不到。Agent 想违反,连编译都过不去。
4.3 禁掉 99% 的注释
这条最反直觉,也是争议最大的。
她的理由有三层:注释老化得很快;没什么人真的读;更糟的是,注释给 agent 留了后门。
真实事故是这样的。在 Cursor 里,agent 特别喜欢用命令式定时器,setTimeout、requestAnimationFrame、requestIdleCallback,用它们去打补丁,弥合 VS Code 命令式风格和 React 声明式风格之间的架构冲突。
JavaScript 里定时器被大量创建销毁会带来频繁 GC,性能直接掉。而 agent 在每处补丁旁边写了注释,解释为什么这个临时方案是合理的。
等他们反应过来,定时器已经到处都是,性能明显下滑。
五、注释为什么是后门
这一节值得单独展开,因为它触及了一个更普遍的问题:为什么 agent 特别擅长用文字为自己开脱。
第一,注释不是强制的。你写一句「提醒下一个 agent 不要这么做」,看起来是好意,但它永远不会变成你可以依赖的东西。没人会跑一遍检查确认注释还在,也没有 CI 会因为你删了注释而失败。
第二,注释是 agent 的自我辩护材料。这一点在代码里表现得特别明显:当 agent 决定用一个临时方案时,它会写一段注释论证这个方案的必要性。这段注释在下一个 agent 看来,是一条来自「前人」的、有上下文的、可信的经验。
第三,注释会过期。三个月后架构变了,注释还在。那个「暂时这样」的临时方案,被注释固化成了长期方案。
她的处置是:把 lint 规则做成唯一合法的表达渠道,而且错误信息要写得对 agent 友好,直接指向根因,而不是给它一个继续打补丁的许可。
这里有个容易被忽略的设计点。错误信息是给人看的,还是给 agent 看的,写法完全不同。给人看的报错可以是 no-restricted-syntax,给 agent 看的报错要写成一句话:「这里用了 useEffect,请把副作用提到 Dune 的 effect 层,或者改成数据流」。后者能让 agent 一次改对,前者会让它试三次然后加个 disable 注释。
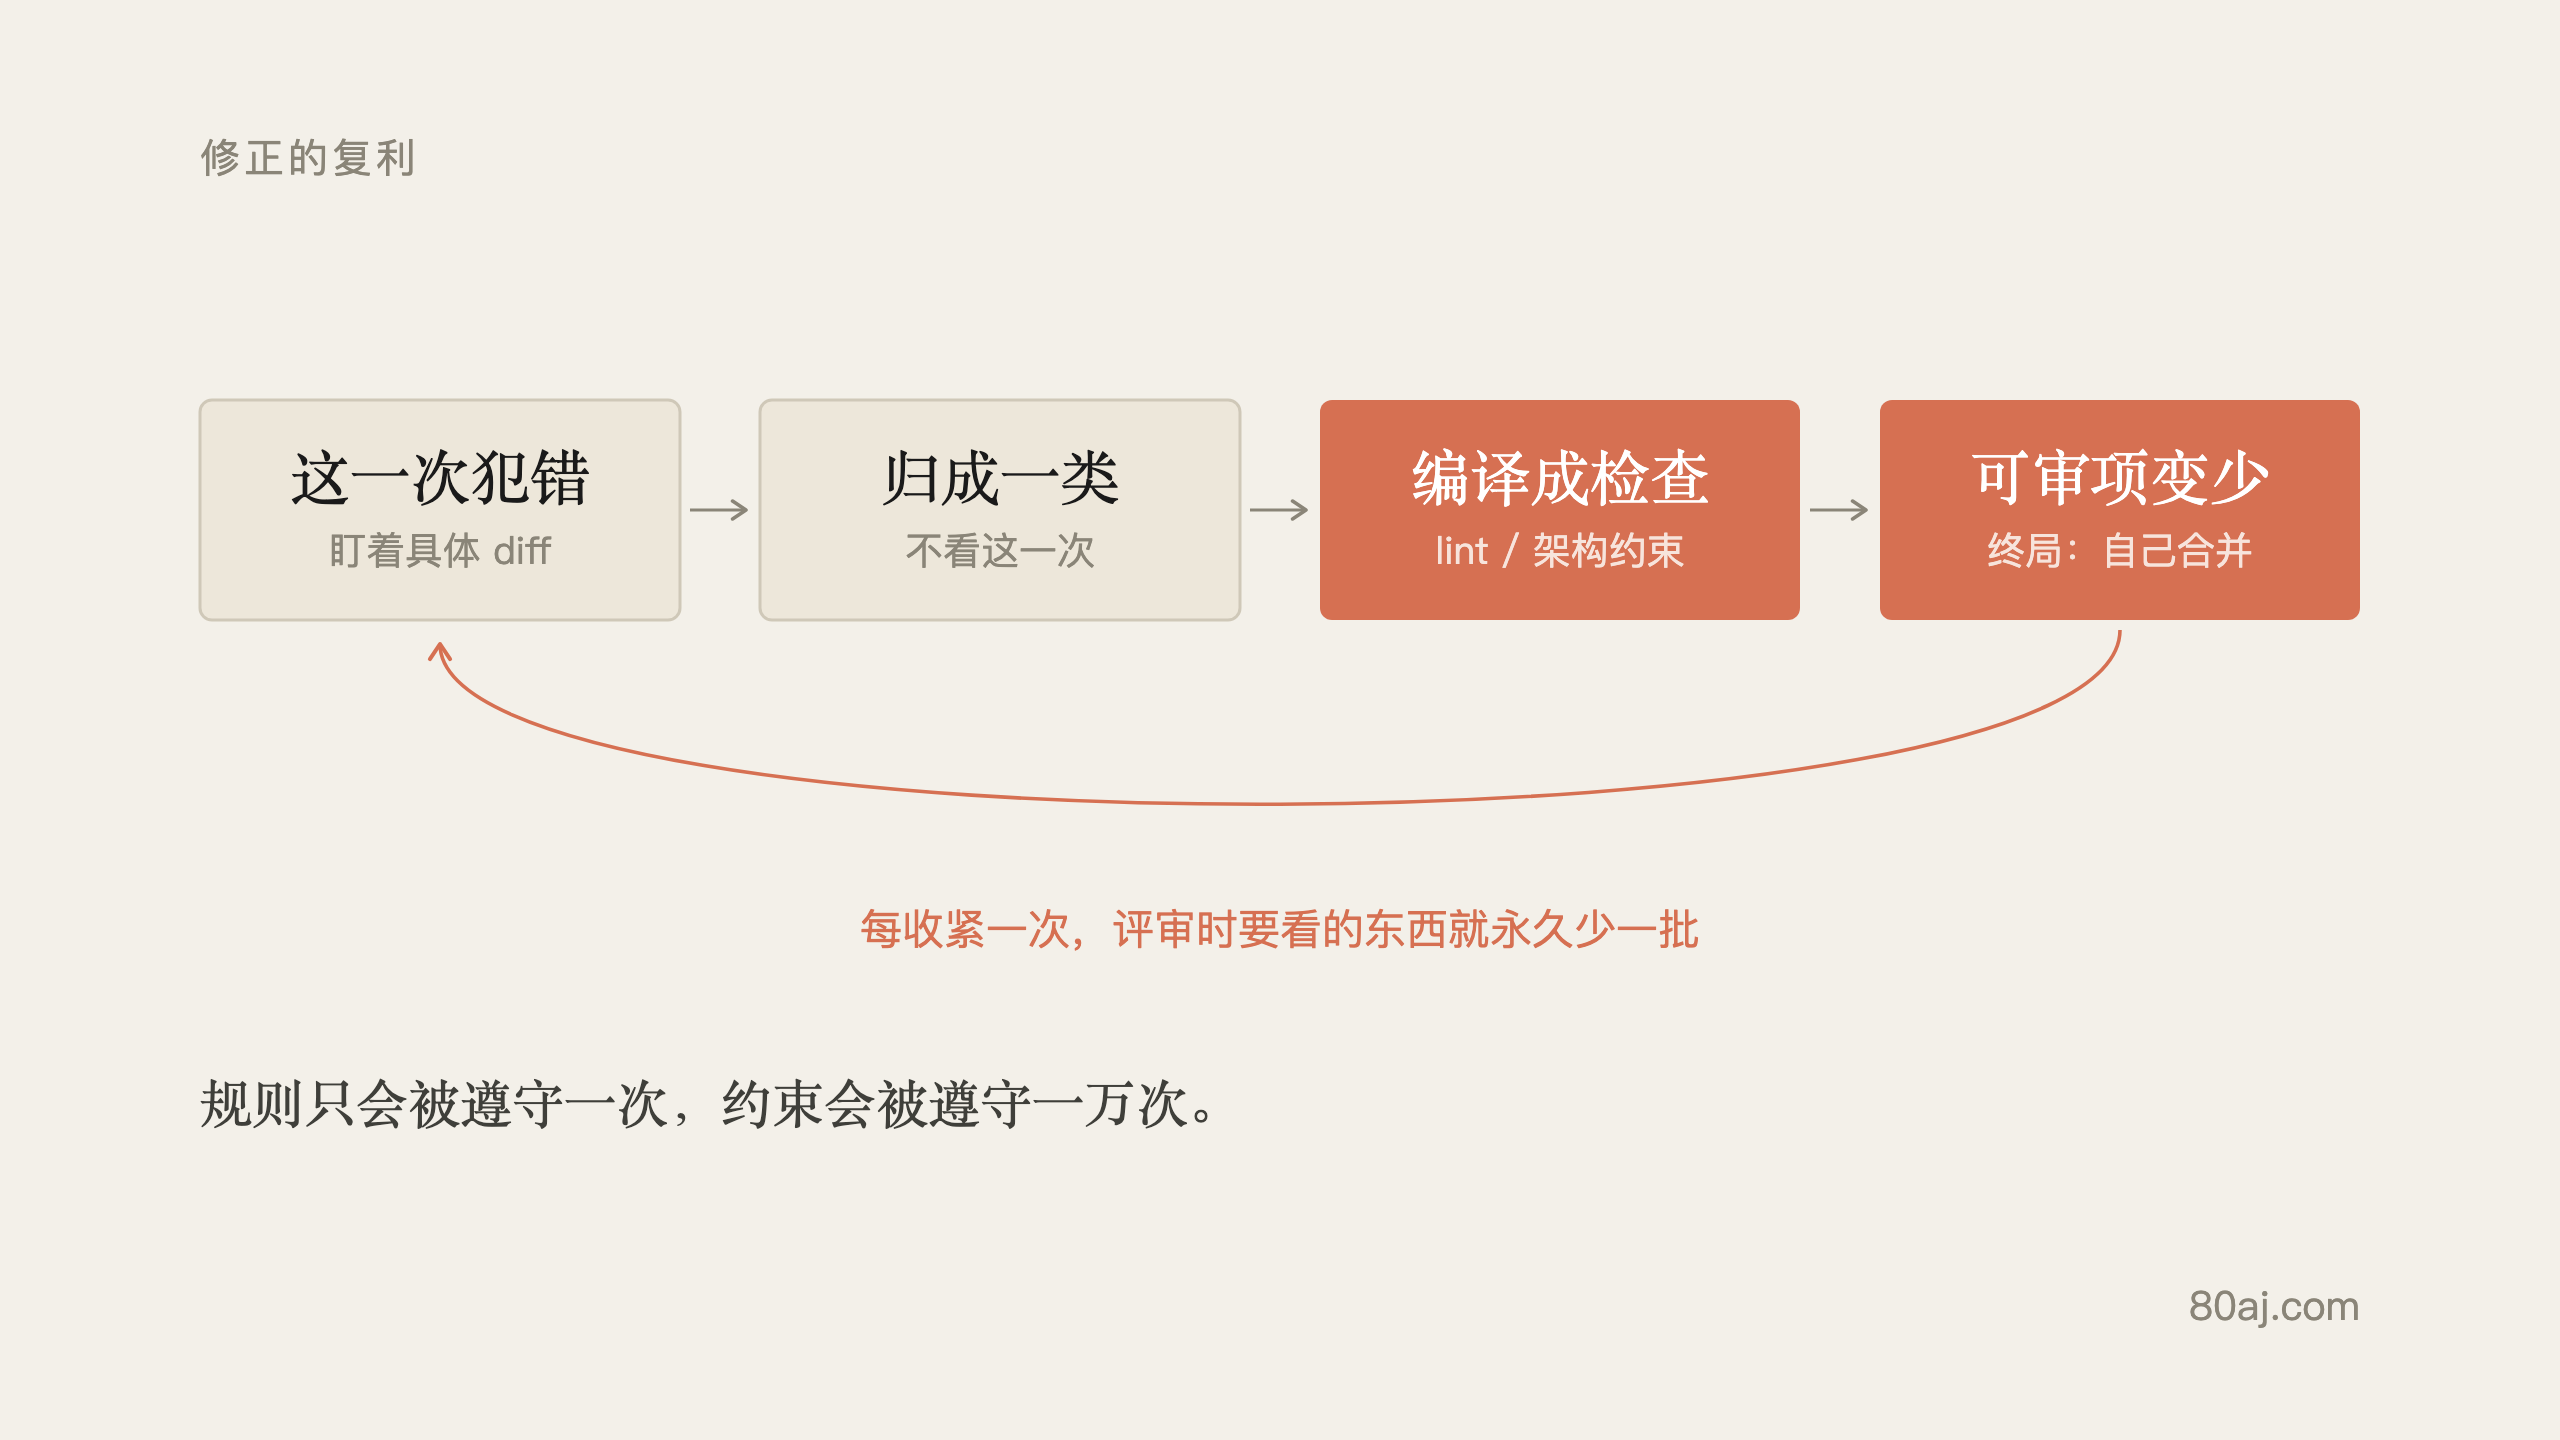
六、核心机制:修一次,编译一次
上面三件事背后是同一条原则,我认为这是整场分享唯一必须记住的一句:
每当我们修 agent,就把它变成确定性检查;或者想清楚怎么通过更好的 API 设计和架构,在代码里彻底消除这个问题。
这句话的结构值得注意。它给了一个二选一,但两个选项都是「一次性解决一整类问题」,没有「再提醒一次」这个选项。
这个机制的杀伤力在于复利。做够多次之后,你在 code review 里需要考虑的东西越来越少。到某个点,你会发现自己没什么可看的了。那时候就可以让 agent 自己合并大部分 PR。
她的团队现在就是这个状态:大部分产品代码不再需要深度人工评审,PR 默认成功。
这里有个转折需要说清:自动化不是靠「信任 agent」换来的,是靠「让错误变得不可能」换来的。信任是结果,不是前提。
多数团队把顺序搞反了。先担心 agent 不可靠,于是加规则、加评审、加人工卡点,然后发现卡点越加越多,效率反而下降。正确的顺序是先收紧环境,收紧到没什么可错的,卡点自然就撤掉了。
为什么 lint 比 prompt 可靠:执行位置决定可靠性
这一节可能有点技术,但它是整套方法的地基,值得说清。
提示词的执行位置在推理之前。它改变了模型「看到什么」,但不保证模型「做什么」。模型可以读到「禁止 useEffect」,然后在生成代码时因为它觉得这里有个特例而照样写。你事后检查时才发现,而检查本身又是靠人或者靠另一遍模型,成本很高。
lint 的执行位置在提交时。它不改变模型看到什么,它保证模型做出来的东西如果越界就进不去。这两者的可靠性差一个数量级。
更关键的是覆盖面。提示词只在模型注意到的地方起作用。一个复杂任务里有几十个决策点,模型对提示词的注意力会随着上下文增长而衰减。它可能记住了「不要 useEffect」,但在处理第六个子任务时忘了。Lint 没有注意力问题,它扫描所有到达该状态的代码路径,一视同仁。
还有一个隐蔽差别:可测试性。一条 lint 规则你可以写一个测试用例证明它有效:故意构造一段违规代码,看它是否报错。一条提示词规则你没法测试,你只能观察它这次守没守,而下次可能就不守了。
所以「把规则降级成检查」这件事的本质,不是形式主义,是把一个概率性约束换成一个确定性约束。前者你要反复确认,后者确认一次就永久生效。
信任是被验证出来的,不是被承诺出来的
她那套结构的名字叫信任金字塔,但整场分享里她一次都没说「要相信 agent」。
这个细节值得注意。她讲的是「投资 agent 的环境,这样你才能确定它们会做对」。顺序是:先有确定性,再有信任。信任是确定性的副产品。
现实里多数团队的顺序是反的:先试着相信,出问题后再收紧,收紧到没人敢用。这个循环走两轮,团队就会得出「agent 不靠谱」的结论,然后停在人工卡点上。
按她的路径,信任是分层建立的,每一层对应一类可以自动判定的错误:
| 信任层级 | 你能确认什么 | 对应的动作 |
|---|---|---|
| 第一层 | 代码能编译、类型正确 | 允许 agent 提交 |
| 第二层 | 测试通过、覆盖了改动路径 | 允许 agent 开 PR |
| 第三层 | 运行时验证产物符合预期 | 允许人工只看证据 |
| 第四层 | 回退率稳定在阈值以下 | 允许自动合并 |
关键是每一层的准入条件是可观测的数字,不是感觉。你觉得它行了不算,回退率低于 1% 才算。
这个框架的实际用途是:当有人说「我们准备好让 agent 自动合并了吗」,你不用争论,去看数字落在哪一层。
七、验证:评审对象从代码变成证据
他们的 code review 现在基本等于看验证产物:视频、截图、图表、形式化证明。
这句话第一次听会觉得不严谨。不看代码怎么保证质量?但仔细想,人看代码能发现的东西本来就有限,实话说大部分 review 是看风格和显而易见的问题。真正难发现的跨文件陷阱、时序问题、状态机死锁,人眼也看不出来。
7.1 运行时验证与 feature map
运行时验证说白了就是让 agent 自己跑代码,用上人也在用的调试工具,比如 Chrome DevTools 协议。
这里有个很实用的设计,他们叫 feature map,本质是从用户视角出发的功能站点地图。解决的是指代问题:你说「左边面板那个东西」,agent 只能猜;有了共享词汇表,它能对上是哪个功能。
这个思路可以推广。任何你跟 agent 协作时反复出现的表述歧义,都该变成一份结构化的对照表,而不是每次在对话里解释一遍。
7.2 自建 CLI 省 token
他们让 agent 复用自家的 CLI 和 driver,而不是每次都重新生成调用方式。省 token 只是一半的好处,另一半是 CLI 本身可测试。
这条对做平台的团队更有参考价值。Agent 每次重新拼装 HTTP 请求,既浪费 token 又容易错;包一个 CLI,等于把「怎么调用」这件事固化下来,顺便让它进了版本管理。
7.3 TLA+ 与 Lean
形式化验证他们刚开始用。
TLA+ 用来验证核心用户流程的模型,比如跨设备、跨平台的通知链路。Lean 用来证明某些算法,他们自己写了虚拟化库,用 Lean 保证不闪、不抖。
她自己也说这不是万能药,只是环境里多一层工具,整体还在试验阶段。
7.4 属性化 UI 测试
用了一个叫 Bombadil 的库做属性化接口测试,已经抓出几个界面 bug。
到这里可以看出一条线索:她用的每一样东西,都不是为 AI 新造的。TLA+ 是 1999 年的东西,Lean 是定理证明器,Chrome DevTools 协议是浏览器调试工具,属性化测试在 Haskell 圈用了十几年。
八、为什么说现在是测试的黄金时代
这是整场分享里我最认同的一句判断。
她引了 Cindy 的一条推。半年前 Cindy 说不信任 agent,因为小错误会溜进代码,缺的其实是验证流程。半年后,Cindy 说日常 70% 的 token 花在验证上。Lauren 说这跟她的观察一致,她自己的 token 也大部分花在验证。
然后她给了一个解释:这些验证手段没有一样是新东西,都是好开发工具,只是以前太贵,难懂、难写、难维护。
这个「贵」是具体的经济账。写一套 TLA+ 规格,一个资深工程师要两周,两周里不产出任何功能。写一个属性化测试框架,要有人懂 property-based testing 的心智模型。给每个功能写运行时验证脚本,人工维护成本很高,功能一改脚本就废。
Agent 把这几笔账都打下来了。规格可以让 agent 写,脚本可以让 agent 维护,测试用例可以批量生成,回归失败让 agent 自己去看日志修。
所以真正的变化不是「AI 会写代码了」,是「一些以前做不起的工程实践突然做得起」。这个视角比「效率提升」有用得多,因为它指向了具体的行动:去翻翻你团队当年因为太贵而放弃的那些实践清单。
值得重启的五项老实践
顺着这个思路,我列了几项在 agent 之前普遍被认为「性价比不高」的做法。它们现在都值得重新算账。
| 实践 | 以前为什么不做 | 现在为什么值得做 |
|---|---|---|
| 形式化规格(TLA+ / Alloy) | 写一份规格两周,只有资深工程师能做 | 规格草稿让 agent 写,人只审关键不变量 |
| 属性化测试 | 需要懂 property-based 思维,用例难维护 | 用例批量生成,失败案例自动收敛成回归用例 |
| 依赖方向检查 | 配置复杂,收益抽象,没人愿意推 | agent 会主动违反依赖方向,这项从「锦上添花」变成「必须」 |
| 变异测试 | 跑一次几小时,报大量等价变异,人工筛不过来 | agent 可以批量判断哪些变异是等价变异 |
| 运行时契约断言 | 影响性能,生产环境不敢开 | 可在测试环境和预发全量开,agent 读断言失败日志自己修 |
挑一项的话,我会先做依赖方向检查。理由是它的投入最小,而 agent 最容易犯的就是这类错误,因为在它眼里所有文件都是可 import 的。
九、数字要怎么看
这类分享最容易变成数字崇拜,所以每个数字都得掰开看。
| 数字 | 基准对照 | 意味着什么 |
|---|---|---|
| 11000 个 PR/月(团队) | 传统团队月均百级,中型团队千级 | 单看没意义,分母是 10 月有 227 人提过 PR |
| 3000 个 PR/月(她个人) | 一个工程师月均 10 到 30 个 PR | 她说很多是睡觉时发的 |
| 0.5% 回退率 | 业界对「健康」的默认预期是 1% 到 5% | 这是最硬的一个数:产量翻百倍,质量没塌 |
| 每天一个稳定版 | 桌面客户端常见月更或双周更 | 发布节奏被 agent 产能推着走 |
| 半年 | 她个人从零到能在睡觉时发 MR | 这是入场券的价格,不是可选项 |
最该盯的是 0.5% 和 227 人同时出现。
227 人里相当一部分是偶尔贡献者,没有完整上下文。这种人在传统流程里最容易产出需要反复返工的代码,因为他们不了解约定,也不熟悉历史决策。有 227 个人还能把回退率压在 0.5%,说明防线不在人的水平上,在环境上。
反过来说,如果一个团队只有十个人,全是熟悉代码的老手,0.5% 的回退率并不能证明他们的环境建设得好。样本不同,数字的意义就不同。
十、三个反直觉的判断
整场分享里有三处说法跟主流直觉相反,我觉得都值得记下来。
第一,规则越少越好,因为每条规则都该被降级。 主流的做法是规则越写越多,覆盖越来越细。她的做法是规则写一条、降级一条,最终规则文件只剩下那些真的没法机器化的判断。
第二,禁注释比禁代码更有效。 大家默认注释是好事,是文档,是传承。她的观察是,在 agent 场景下注释主要起了「给偷懒找个说得过去的理由」的作用。
第三,自动化之前要先做减法。 多数团队想的是「把重复劳动交给 agent」,她说的顺序是先让代码库里没有值得重复的坏东西,再自动化。如果内部写代码这个循环本身在产出垃圾,自动化它只会产出更多垃圾,然后你要花越来越多 token 去修。
第二部分:使用
前面讲的是认知。这一部分讲怎么用,按落地顺序排。
十一、第一步不是换工具,是挑一条重复的评论
如果你现在就想动手,别去看什么 lint 配置大全,先做一件事:翻你最近的 code review,找一条你重复说过三次以上的评论。
典型的有这些:
- 「这里不该直接调 API,走 service 层」
- 「这个异常没处理」
- 「别在这个文件里 import 那个模块」
- 「这个查询没加索引条件」
- 「这个 useEffect 依赖不完整」
挑出现频率最高的一条,把它变成机器检查。这一条改完,你团队每周能省下几十条重复评论,而且这条评论以后不会再出现。
这个起步方式的好处是不需要立项、不需要预算、不需要说服任何人。你自己一下午就能做完一条。
十二、lint 规则怎么写才对 agent 有效
三条原则,按重要性排。
第一条,报错信息写给 agent 看。 默认的报错是给懂这个规则的人看的,agent 不懂。你要在报错里写清三件事:你错在哪、根因是什么、应该改成什么样。
// eslint.config.js
{
  rules: {
    'no-restricted-syntax': ['error', {
      selector: "CallExpression[callee.name='useEffect']",
      message:
        '产品代码不允许 useEffect。副作用请提到 Dune 的 effect 层;' +
        '如果是数据获取,用 useQuery;如果是事件订阅,用 useSubscription。' +
        '不要用 eslint-disable 绕过,这条规则没有例外。',
    }],
  },
}
代码块末尾那句很重要。「这条规则没有例外」能挡掉一大半的 disable 注释。
第二条,优先管方向,别管细节。 检查「renderer 不能 import main」比检查「函数不能超过 50 行」有用得多。前者管的是架构方向,后者管的是风格偏好,后者 agent 很容易用拆分函数绕过。
用 dependency-cruiser 做方向检查:
// .dependency-cruiser.js
module.exports = {
  forbidden: [
    {
      name: 'no-main-from-renderer',
      severity: 'error',
      comment: '渲染进程不能引用主进程代码,会导致长任务和界面卡顿',
      from: { path: '^src/electron-renderer' },
      to: { path: '^src/electron-main' },
    },
  ],
};
第三条,规则要能被绕过检测。 允许 eslint-disable 的团队,等于没有规则。做法是把 disable 的数量做成 CI 指标,只允许下降不允许上升。
这三条做完,你会发现 lint 从「代码风格工具」变成了「架构约束工具」。这是它在 agent 时代的正确定位。
三种常见的写错方式
反过来说,有三类 lint 规则写了等于没写。
第一类,管风格不管方向。 检查函数行数、变量命名、import 顺序。这类规则 agent 很容易满足,也完全不影响它把设计做歪。它把一个两百行的函数拆成四个五十行的函数,架构问题一点没解决。
第二类,报错不指路。 只写「禁止使用 X」。Agent 收到这个报错,第一反应是找绕过方式,而不是理解意图。想让它改对,必须告诉它替代路径。
第三类,允许例外。 只要 eslint-disable 能生效,这条规则的强度就取决于 agent 的自觉性。可行的做法是把 disable 数量做成 CI 门禁,只许降不许升;更彻底的做法是这类架构规则直接禁止 disable。
一条规则的强度,取决于它被违反时会发生什么。构建挂掉是强,报个 warning 是弱,写进文档是零。
十三、AGENTS.md 该缩到多短
按她的逻辑,AGENTS.md 里每一条规则,你都该问一句:这条能不能变成机器检查?
能,就搬走,别留在这儿。不能,才留下。
按这个筛法,一份典型的两百行 AGENTS.md 大概能剩下二十行。剩下的应该是这些:
| 留下的 | 搬走的 |
|---|---|
| 项目的业务背景和目标用户 | 「不要用 any」(类型系统管) |
| 哪些目录是禁区 | 「import 要排序」(linter 管) |
| 提交信息的格式 | 「不要用 useEffect」(lint 管) |
| 遇到不确定时的升级路径 | 「测试要覆盖边界」(CI 管) |
留的部分有一个共同点:它们描述的是意图和边界,机器判断不了。搬走的部分有一个共同点:它们描述的是具体做法,机器能判断。
这个筛法还有个副作用:AGENTS.md 变短之后,agent 的遵守率反而上升。文件太长时,模型会漏读中段,而且不同段落的规则冲突时它不知道听谁的。
十四、验证闭环的最小可用版本
不用一上来就上 TLA+。最小闭环是三步。
第一步,给 agent 跑起来的能力。 让它能执行代码、能读日志、能开浏览器。这一步很多团队还没做,agent 只能改代码不能验证,等于闭着眼睛改。
第二步,定一份 feature map。 一页纸,把产品的功能按用户视角列出来,每个功能对应哪些页面、哪些操作、哪些状态。这份东西是给 agent 消除歧义用的。
第三步,把验证产物存档。 截图、录屏、trace、测试报告,全进 PR 描述。人的评审从「读 diff」变成「看证据 + 抽查 diff」。
三步做完,你就有了一个能自我验证的循环。后面加 TLA+、加属性化测试,都是在这个基础上叠。
把一次对话变成一条规则的五步
这是我认为最该固化成习惯的一个动作。她现在每次修 agent 都这么做,多数人只是改完就过。
第一步,记录触发场景。 不要只记「agent 又写错了」,要记它当时在做什么、看到什么上下文、做了什么错误决定。这个记录是后面抽象的材料。
第二步,抽象成类别。 问一句:如果换个功能、换个文件,它还会不会再犯同样的错?会,就是一类问题;不会,就是偶发失误,直接改掉就行。
第三步,判断能不能机器化。 能不能用一句代码查询把这种模式找出来?能,往下走;不能,说明它是个需要判断力的问题,写进 AGENTS.md 并配一个正反例子。
第四步,写法决定强度。 机器化的写成 lint,报错里带根因和替代路径;写规则的补一句「为什么」,因为判断类问题只能靠理解。
第五步,验证拦截有效。 故意构造一段违规代码,看规则有没有拦住。没拦住说明写错了位置或条件。这一步九成人会跳过,跳过之后你以为有了防线,其实没有。
五步走完,一次具体的失误就变成了永久的环境改进。这个动作跑一百次,你就有了她说的那个状态:评审时没什么可看的。
验证产物具体长什么样
「看验证产物」这句话很抽象,落到实操需要一份清单。按我理解她那套做法,一份合格的 PR 描述应该包含四块内容。
第一块,改了什么。 一句话说清这次改动解决了什么问题,不写实现细节。这一块是给未来的自己看的。
第二块,怎么验证的。 列出跑过的检查:单元测试、集成测试、类型检查、lint。每项给结果,不给结论词(不要写「测试通过」,写「142 passed, 0 failed」)。
第三块,证据。 界面改动给改动前后截图,交互改动给录屏,流程改动给状态图或时序图。这部分是替代「人读 diff」的关键,没有它评审就退回到通读代码。
第四块,已知风险。 这次改动影响了哪些模块,哪些地方没验证到,回滚方式是什么。这一块最容易省,但它是自动化合并的安全网——出问题时你不用猜,直接按写的回滚。
这四块加起来,一个 PR 的评审时间可以从二十分钟压到三分钟。压缩的不是深度,是找信息的成本。
十五、平台侧:把四层映射到 agent 平台
如果你在做 agent 平台,这套结构几乎是现成的架构参照。
| 她的层级 | 平台里对应的东西 |
|---|---|
| 代码库与架构 | 权限模型、接口 schema、模块边界,让 agent 不可能越权或越界 |
| 工具链 | 类型定义、契约测试、静态检查,在提交前就拦掉 |
| 验证层 | 沙箱执行、trace 回放、hook 拦截、状态机断言 |
| 描述性指令 | 系统提示、skill、工具描述、AGENTS.md |
| feature map | 工具能力清单 + 用户视角的功能地图 |
| 外循环 | 定时调度 + 状态机 + 多 agent 编排 |
这里有个判断标准可以带走:你的平台把「防错」放在哪一层,决定了它的可靠性上限。 靠提示词防错的平台,永远在跟模型的随机性搏斗;靠 schema 和沙箱防错的平台,错误在结构上就发生不了。
十六、个人侧:一个人怎么用出 3000 个 PR
她个人一个月 3000 个 PR,这个数听着夸张,拆开看是合理的。
前提是她所处的环境已经把「判断成本」降到了很低。她的每个 PR 不需要重新解释背景,不需要来回确认架构方向,因为方向已经写进 lint 和目录结构了。她能发这么多,不是因为她打字快,是因为每个 PR 需要她做的决策少。
个人要复制这个路径,能做的有三件:
第一,把自己的项目边界定死。 目录结构、模块职责、依赖方向,先想清楚再写代码。边界清楚的项目,agent 一次能做对的范围大得多。
第二,写自己的 verification script。 一个能跑起来验证「这次改动有没有破坏核心功能」的脚本,比十条提示词有用。
第三,把重复的解释沉淀下来。 你每次跟 agent 解释同样的事,就该把它变成一份文件,而不是下次再说一遍。这份文件最终会变成你的 feature map 加 AGENTS.md。
十七、30/60/90 天路线
如果要在团队里推,我给一个保守的节奏。
第 1 到 30 天:只做一条规则。 挑最高频的那条 review 评论,写成 lint,跑起来,观察一个月它被触发了多少次。这个数字会说服你自己。
第 31 到 60 天:做目录边界和验证脚本。 把最容易出问题的依赖方向用工具锁住,同时写出第一个能自动验证核心功能的脚本。这一步的产出不是效率,是「感敢让 agent 自己跑」。
第 61 到 90 天:开一个小范围的自动合并。 挑一个低风险模块,让 agent 的 PR 在 CI 全绿的情况下自动合并。观察回退率,如果稳定在 1% 以下,扩大范围。
这里最容易失败的地方是第 90 天之后。自动合并跑通了,团队会急着扩大范围,然后回退率上升,然后回到人工卡点,然后放弃。她的做法是每次回退都问「这一类问题能不能在代码层面消除」,而不是「要不要加一条规则」。
第三部分:边界
她的分享有说服力,但有几处需要打折扣,不然容易被当成万能药。
十八、六个要打折的地方
第一,入场成本是半年,而且她没说团队规模。 227 人提 PR 说明这是个几百人的组织。几百人半年的人力投入去建 lint 体系、验证基础设施、自研框架,这个账在几十人的团队里算不过来。她提了一句「你可以比我快得多」,但没说依据。
第二,Electron 客户端是相对封闭的领域。 UI 状态可枚举,功能边界清楚,所以 feature map、属性化 UI 测试、Lean 证明虚拟化库这些做法成立。换成分布式后端、数据管道、有强合规要求的金融系统,同样思路要重新设计一遍。
第三,形式化验证的实际覆盖很窄。 TLA+ 只覆盖了通知这一条流程,Lean 只覆盖了一个虚拟化库。她说「已经找出很多错误」,但没有量化。这块目前是探路,不是主干。
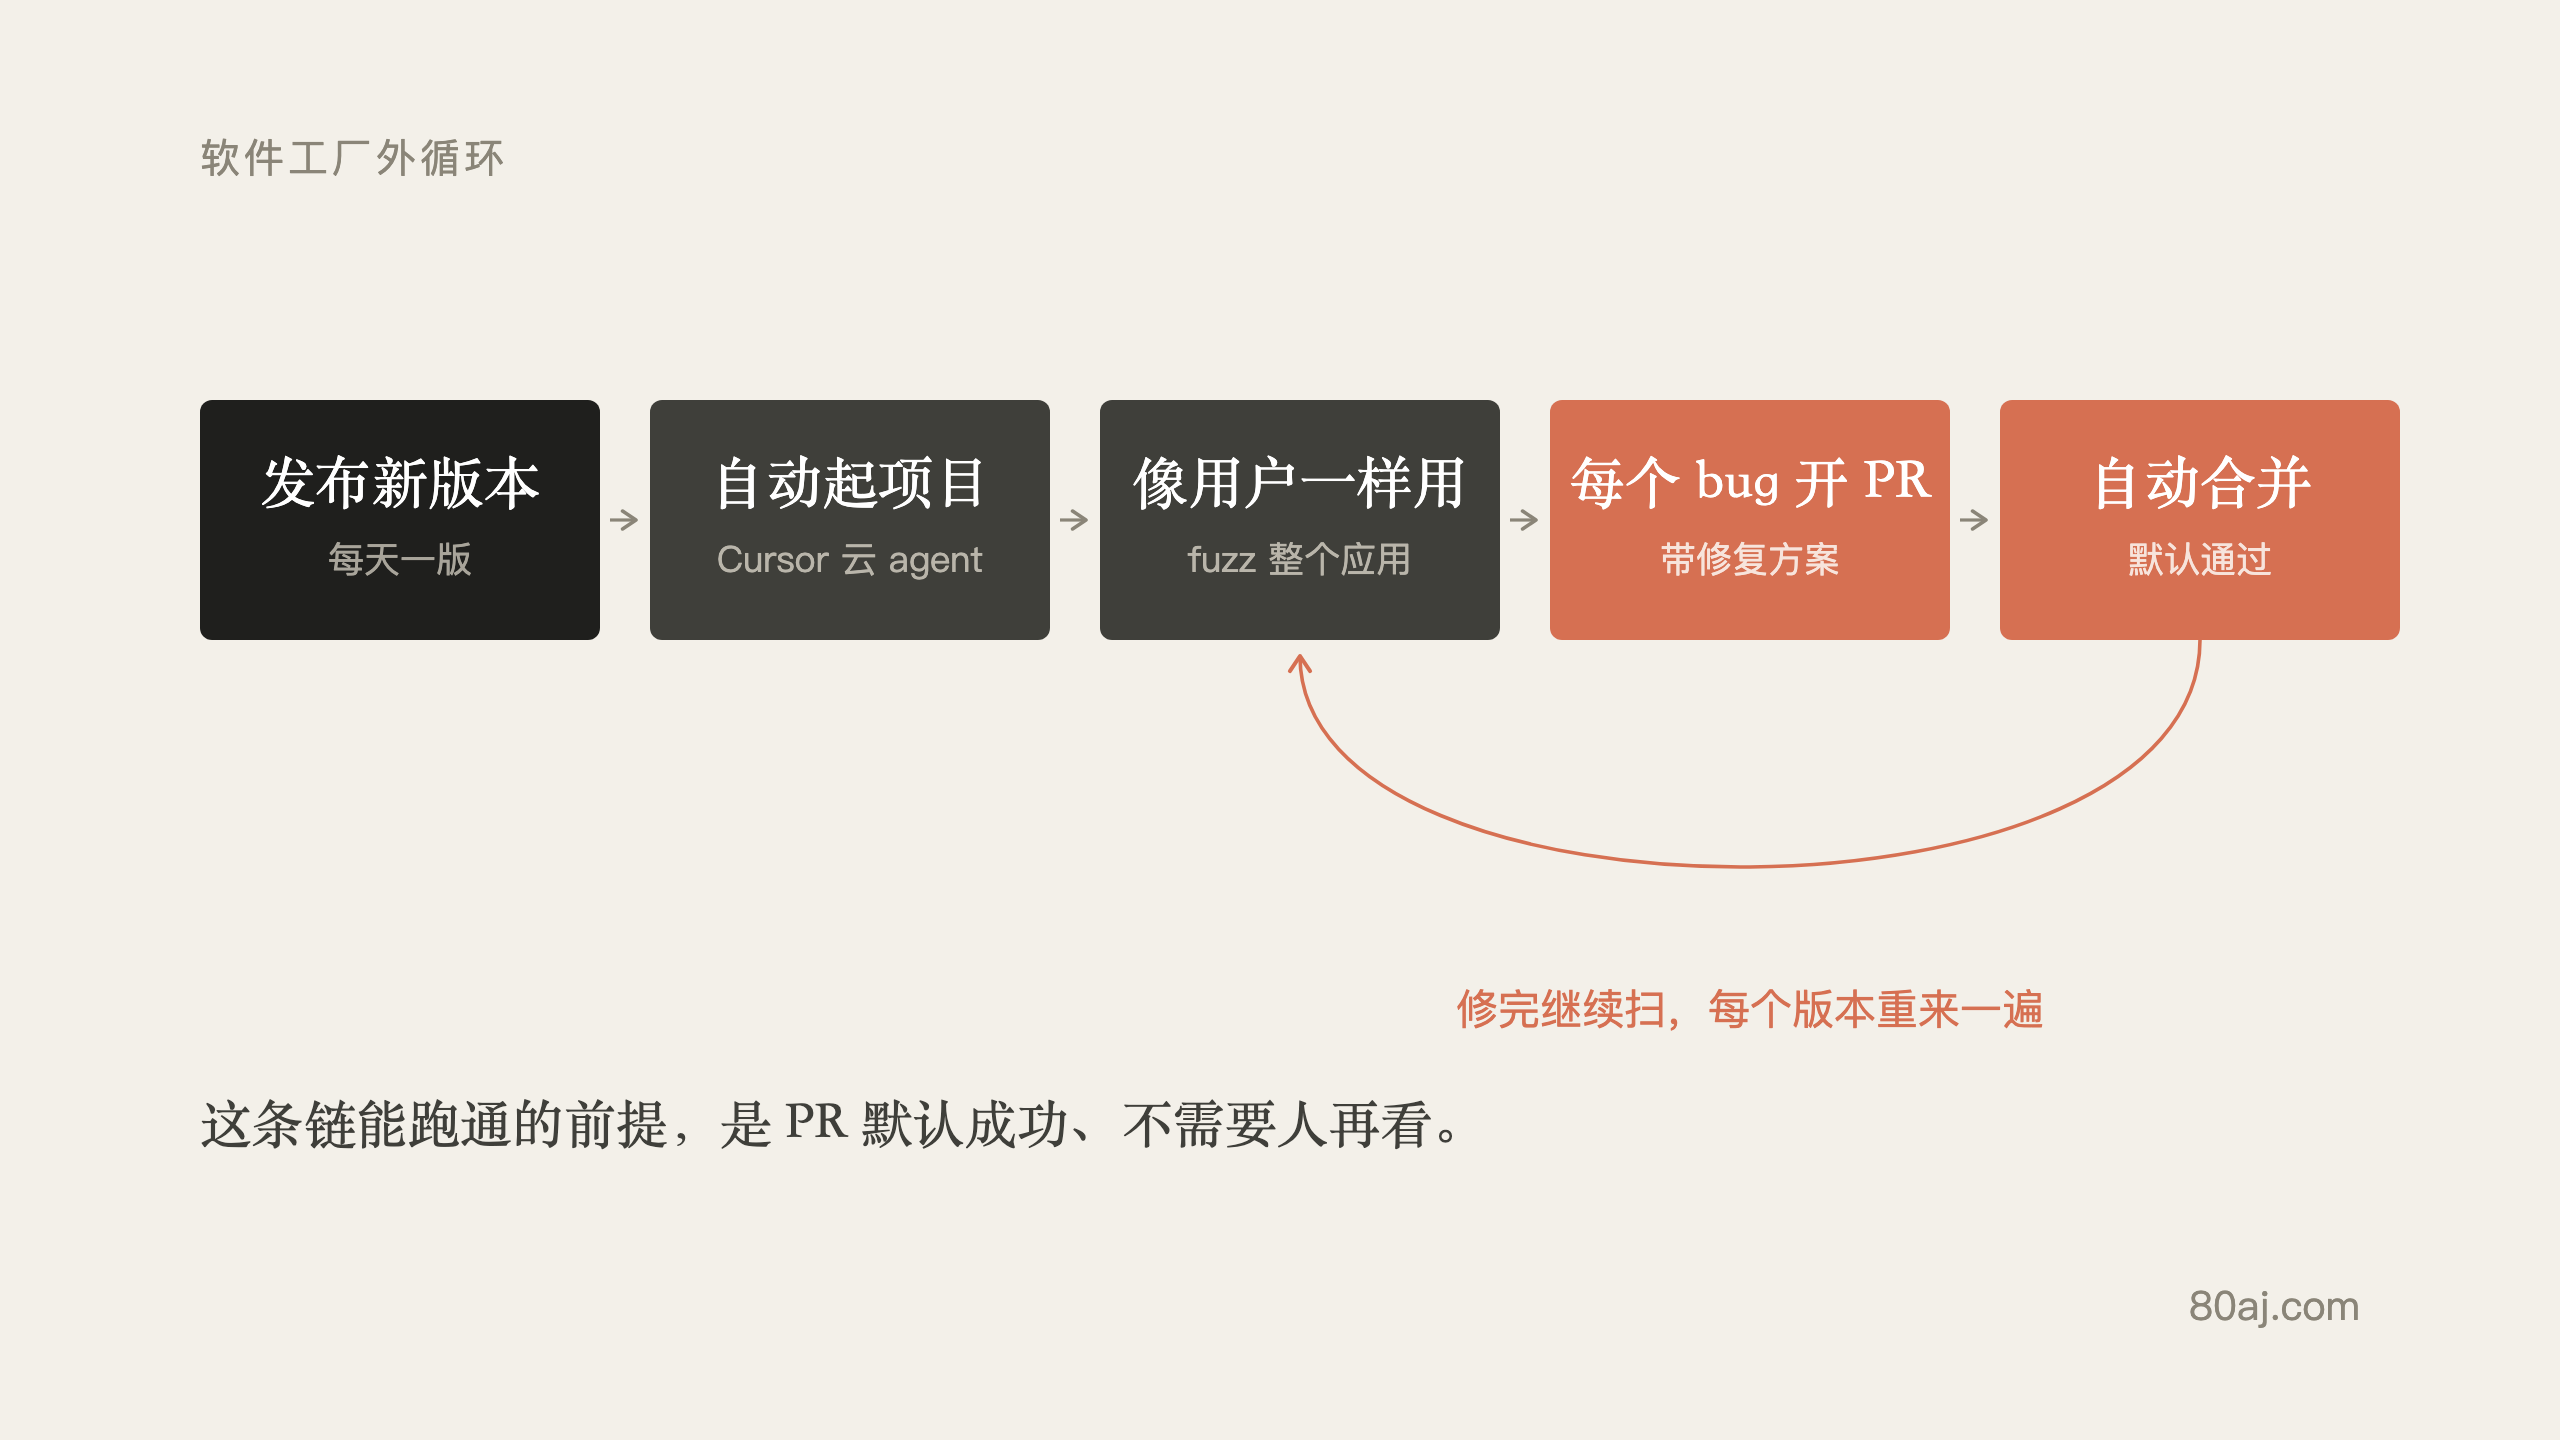
第四,11000 个 PR 的口径要小心。 里面包含 agent 自动生成的修复 PR。她描述的发布流程是:每次发版,Grok Bot 自动在 Cursor 里起项目,对整个应用做 fuzz,像真实用户一样用,发现问题就开 PR 修,自动合并。这类 PR 数量会非常大,不能等同于人类的有效功能产出。
第五,禁注释在有些场景不成立。 业务规则、合规要求、算法出处这类信息必须留在代码里。她的语境是客户端产品代码,注释的主要成分是「解释为什么这样写」,那确实可以砍。
第六,隐性门槛是「团队能写 lint 规则」。 写一条能准确表达架构意图、又给出可执行错误信息的 lint 规则,是稀缺能力。多数团队连 ESLint 配置都是抄来的,抄来的规则写不出好报错。
这套方法对模型迭代不敏感,这既是优点也是局限
有个角度值得单独说,因为她没提。
她的整套体系建在代码层。Lint 规则、目录边界、类型系统、验证脚本,这些东西跟用哪个模型毫无关系。换成更强的模型,这套约束照样生效;换成更弱的模型,它反而更值钱,因为弱模型更容易犯错,约束帮你兜住。
这是优点:环境建设的投入不会因为模型换代而贬值。多数「提示词技巧」的保鲜期是三个月,模型一升级就失效。
但同一件事反过来看是局限。模型能力提升是免费的,你什么都不做它也会变强。环境建设要花人力,而且见效慢。所以在任何一年里,「等模型变强」永远是比「建环境」更省事的选择。
这个选择在短期是对的,长期会吃亏。因为约束的收益是复利的,模型变强带来的收益是线性的,而且天花板受限于你给了它什么样的工作环境。一个在烂代码库里跑的强模型,产出还是烂代码。
十九、什么团队不该抄
有三种情况,这套方法会明显亏本。
交付压力极大、几乎没有重构窗口的团队。 建环境需要时间,这段时间产出是下降的。如果团队正处在生死线上,先活下来。
代码量很小、生命周期很短的项目。 三个月的项目,花两周建约束体系不划算。这类项目直接上 agent 加人工评审更实际。
没有明确架构的项目。 她的方法前提是「架构方向是清楚的,只是需要被机器执行」。如果架构本身没想清楚,写不出有意义的 lint 规则,写出来的只是风格检查。
我的补充
二十、我会怎么用
她的框架我用得上的地方有三处,说具体一点。
第一,把「修一次」当成硬性动作。 我现在的习惯是 agent 犯错就改这一次,改完继续。她的做法是每次犯错都问一句:这是不是一类问题?如果是,当场变成检查。这个动作的成本是每次多花五分钟,收益是这一类问题永久消失。我打算把它写成自己的检查清单。
第二,报错信息当成文档写。 我们团队的 lint 报错基本是默认文案,agent 看了不知道怎么办,只能猜。改写成「你错在哪、根因、应该改成什么样」,这个投入很小,收益是 agent 一次改对的概率明显上升。
第三,验证产物入库。 我们现在的评审还是读 diff。截图、录屏、trace 这些证据没有进 PR,人只能靠想象判断「改了之后界面对不对」。把证据补上,评审质量会明显不一样。
她讲的 AGENTS.md 收缩,我持保留意见。原因是我们的规则文件里有一部分是「业务判断」,比如某类客户的数据不能出现在某个页面上,这种规则确实没法完全机器化。但可以机器化那部分确实该搬走,这个方向我认。
我还没想清楚的两个问题
第一个,环境的维护成本拐点在哪。 Lint 规则会越积越多,每条都要人维护,规则之间还可能冲突。写到两百条时,团队的精力会不会被规则本身吃掉?她没提这件事,我猜他们团队有专门的人做这块。小团队没有这个角色,拐点会更早到。
第二个,怎么在没有平台工程师的团队里复制。 她的方法默认团队里有人能写依赖图分析器、能写自定义 lint、能搭验证基础设施。这是平台工程师的活。十几个人的产品团队通常没有这个人,那么这套东西的最初几步该怎么起步,她没给答案。
我的临时答案是:从开源现成规则集起步,只做加法和配置,不自己发明。等团队真的感觉到约束的价值,再投人做定制。这跟她的路径不一样,但对小团队更现实。
最后
她在结尾说,在建软件工厂、把能自动化的都自动化之前,先把自己的代码库调好。如果内部写代码这个循环本身在产出垃圾,自动化它只会产出更多垃圾,然后你要花越来越多 token 去修。
这句话对当下的意义比对她的团队更大。多数团队已经在上自动化了,代码库还是原来那个。
如果你只记一件事,记这个顺序:先清债,再加约束,再上验证,最后才谈自动化。中间跳过任何一步,后面都会用 token 还回来。