把工具当成“注册一个函数”是新手最贵的误解。模型看不到你的函数体,它只能看到名字、描述和参数 schema——这三样东西合起来就是一份给模型看的接口文档。写成什么样,直接决定模型能不能一次用对。
实验固定每个工具耗时 250 毫秒,跑同一批 4 个调用,只改执行模式,测墙钟时间。
一个工具由四部分组成
工具的接口定义里有四个关键字段:name 是模型调用时用的标识;description 是模型判断“什么时候该用它”的唯一依据;parameters 是 TypeBox 写的参数 schema,会在执行前强制校验;execute 是真正干活的函数,返回内容块和结构化详情。
还有两个可选字段值得单独说。label 是给人看的显示名,界面上用;executionMode 是单工具的并行开关,它能把整批调用拉回串行。
description 最容易被敷衍。写「读取文件」和写「读取文本文件的前 N 行,超过 200KB 会截断,二进制文件返回错误」,模型的表现完全不同。前者它会在任何场景都试一次,后者它知道边界在哪。
一个参数设计得当的工具
import { Type } from 'typebox'

const readFile = {
  name: 'read',
  label: 'Read file',
  description: '读取文本文件的前 N 行。目录不存在或文件是二进制时返回明确错误,不会静默截断。',
  parameters: Type.Object({
    path: Type.String({ description: '绝对路径' }),
    lines: Type.Optional(Type.Number({ minimum: 1, maximum: 2000, default: 40 })),
  }),
  execute: async (toolCallId, { path, lines = 40 }, signal, onUpdate) => {
    const text = await readLines(path, lines, signal)
    return { content: [{ type: 'text', text }], details: { path, lines } }
  },
}
注意:给参数写 description 和约束(minimum、maximum、default)不是形式主义。模型看到 maximum: 2000 就不会传 50000,看到 default 就知道可以省略。省掉这些,你会收到大量参数合法但语义荒谬的调用。
执行模式:并行省三倍,但一个串行就毁掉整批
默认是并行。一轮里模型说要调四个工具,四个会同时开始跑,结束事件按实际完成顺序发出来。这对读日志、查磁盘、探活这类独立操作是最优解。
切到串行,四个 250 毫秒的工具会老老实实排队,总共约 1 秒。什么时候该串行?当工具之间有隐含顺序时——比如先写配置再重启服务,并行会读到旧配置。
真正值得注意的是第三种情况:默认并行,但其中一个工具声明了 executionMode: ‘sequential’,结果整批退化为串行。这个设计很保守,也很正确——它保证不了“部分并行”的语义安全,就干脆全串。
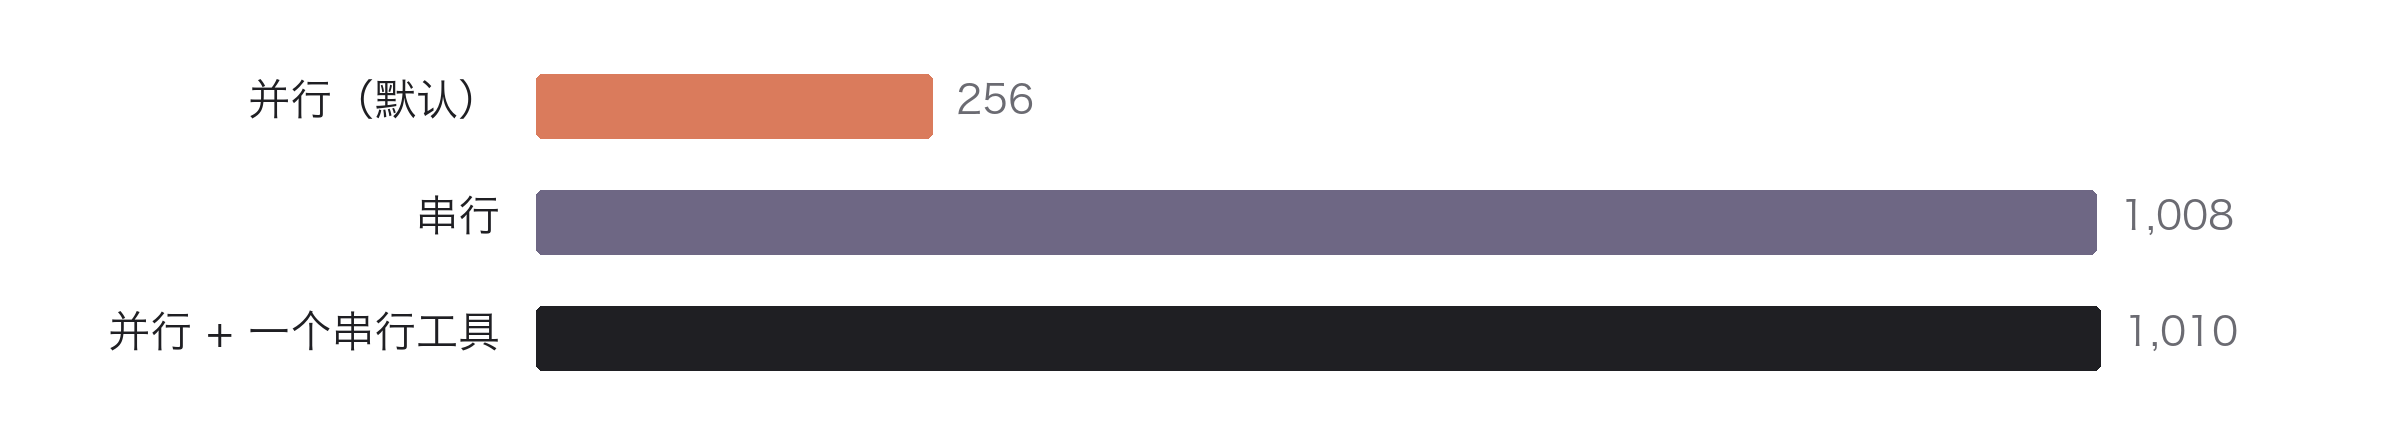
同一批 4 个 250 毫秒的工具:并行 256 毫秒,串行 1008 毫秒,只把一个工具标成串行就退化到 1010 毫秒。整批被拉平,不是按工具分别计。
实测加速比 3.94 倍,接近理论上限 4 倍。多出来的几毫秒是调度开销,可以忽略。
实践建议:默认并行,只给确实有副作用的工具标串行,而且要意识到这个标记会拖慢整批。如果一个高频场景里总有一个工具拖后腿,考虑把它拆成独立的一轮。
失败必须变成模型能读的结果
execute 里抛异常是可以的,循环会把它捕获成错误结果,标上 isError 后交给模型。这比“在 content 里写一句失败了”重要得多——前者模型知道这是错误,后者它会以为任务成功了。
这一点在上一代脚本编排里是重灾区:脚本返回 4,宿主只认 0 和 2,于是模型收到的是一个没有语义的异常。它不是不知道该怎么办,是根本不知道发生了什么。
现在的接口把这条通路修好了:错误有独立标记,内容里有原因,模型可以据此换工具、换参数、或者停下来问人。第 10 篇会给出 20 条用例的实测,四类失败全部送达。
让失败带上下文
execute: async (id, { path }) => {
  try {
    return { content: [{ type: 'text', text: await read(path) }], details: { path } }
  } catch (err) {
    // 不要吞掉原因,也不要只写 'failed'
    throw new Error(`${path}: ${err.code ?? 'UNKNOWN'} ${err.message}`)
  }
}
工具数量的上限在哪里
pi 的官方产品层只给四个工具:读、写、改、shell。这个选择值得琢磨。工具越少,模型的决策空间越清晰;工具越多,选择成本越高,误用概率越大。
经验值:十个以内可以靠 description 区分,二十个以上就必须分组或者按场景动态挂载。上百个工具连着塞进系统提示,模型基本是在猜。
还有一个反向思路——用 shell 合并工具。与其提供 query_db、ping_host、check_disk 三个工具,不如只给一个 bash,让模型自己拼命令。代价是你必须把权限闸门做在钩子里,这正好是第 7 篇的主题。
下一篇转向事件的另一面:工具执行过程中可以往外推进度,这个能力决定了用户是“盯着转圈 600 毫秒”还是“看到进度条在动”。实测首次可见时间差 508 毫秒。
引用与来源
- AgentTool 接口定义(v1.4.0) — 含 executionMode 与 onUpdate 回调
- TypeBox:JSON Schema 类型构造器 — 参数校验依赖