前八篇讲的是循环怎么用,这一篇讲怎么把一个已经在跑的系统换过去。改造不需要推倒重来——把「固定调用」换成「给工具加判断」,把「退出码」换成「结构化结果」,把「暗依赖」换成「显式参数」,三步就能让同一批任务从 20% 通过率走到 100% 有结论。
沿用第 1 篇的 30 个任务集:6 类故障、两类编排器。这一篇逐条对照 7 项差异,并统计 24 个失败任务在改造后的去向。
死法一:调用写死
典型的写法是:平台里写一行 subprocess.run,参数固定为 –log-dir 和 –output-json,脚本名固定,cwd 不传。这一行代码在 80% 的情况下工作良好,所以没人觉得有问题。
问题出在剩下 20%。脚本可能叫 analyze_log.py,可能放在 scripts/ 子目录,可能需要额外参数。每一种变化都要改一次平台代码、发一次版本、等一次审批。改到最后,平台里堆了十几个 if 分支,每个分支对应一个客户现场的目录结构。
改造方式是把调用权交给模型:给它 ls 看目录、read 看内容、bash 执行。模型先看有什么,再决定跑什么。平台代码里一个分支都不用留。
改造前 vs 改造后
# 改造前:一条路走到黑
subprocess.run(['analyze.py', '--log-dir', d, '--output-json'], check=True)

# 改造后:模型自己决定
# 模型看到 ls 输出 -> 发现 scripts/ -> 再 ls -> 找到 analyze_log.py -> 拼命令执行
# 平台只提供三个原语:ls / read / bash
背景:有人会担心「让模型拼命令不安全」。这个担心是对的,但解法不是把命令写死,是在 bash 工具前面加钩子——路径白名单、命令黑名单、预算上限。第 7 篇的实测里,这一步能把危险命令拦到零执行。
死法二:失败语义缺失
脚本世界里,退出码是唯一的结构化信号。0 成功、1 通用错误、2 用法错误、其他是脚本自定义。问题在于:宿主往往只认 0 和 2,其余全部压成「失败」。
被压掉的恰恰是最有信息量的部分。脚本返回 4 可能意味着「数据里有除零,我需要你看一眼」;返回 3 可能意味着「这里没有分析脚本,你要不要直接读日志」。宿主看不懂,模型更看不懂——它收到的是一个没有原因的异常。
更糟的是同码不同义。python 找不到文件也返回 2,脚本主动 exit(2) 表示「交给模型」也返回 2。宿主把两者都当成「交给模型」,于是「脚本不存在」也被当成了「需要模型判断」,模型一脸茫然地收到一个它无法处理的请求。
改造的关键是别再用退出码传递语义。工具应该返回结构化结果:成功带数据,失败带 code 和 message,需要人判断就明确写出来。上层拿到的是对象,不是数字。
实测里最有说服力的是这一类任务:脚本主动返回 2 表示「时间戳跨时区,脚本判断不了先后」。脚本式编排把它当成需要模型介入,但宿主没有接的逻辑,任务就此卡死。循环式编排里,模型拿到这个结果后直接 read 日志,自己给出了结论。同一批 4 个任务,从零通过变成全部通过。
死法三:路径暗依赖
启动子进程不传 cwd,脚本里的相对路径就依赖父进程的工作目录。开发机上恰好对,部署到服务里就不对。这类 bug 最难查,因为它不报错,只是读不到文件然后走默认值。
循环式编排天然规避了这个问题——bash 工具必须显式接收 cwd,模型每次调用都要指定在哪个目录跑。强迫显式,等于强迫正确。
但要注意另一面:显式之后模型可能传错 cwd。所以工具实现里应该校验目录存在,不存在就返回明确错误,而不是让它继承一个默认值然后静默失败。
7 项差异的逐条对照
| 维度 | 脚本编排 | Agent 循环 | 改造动作 |
|---|---|---|---|
| 调用方式 | 固定命令固定参数 | 模型按目录内容拼 | 暴露 ls / read / bash |
| 失败语义 | 退出码 0/2 白名单 | 结构化结果带 code | 工具返回对象而非数字 |
| 退出码歧义 | 同码不同义,无法区分 | 由工具实现消歧 | 错误消息里写清原因 |
| 工作目录 | 继承父进程,静默失败 | 每次显式传 cwd | 工具校验目录存在 |
| 资源预算 | 轮次和超时写死在宿主 | 钩子里计次 | beforeToolCall 加预算闸门 |
| 找东西 | 路径写死,找不到就失败 | 模型自己探索 | 给探索工具而不是给路径 |
| 判断归属 | 脚本判定,宿主无法接管 | 模型拿到结果再判断 | 删除宿主的分支逻辑 |
24 个失败任务的去向
第 1 篇里脚本式编排有 24 个任务失败。同一批任务交给循环之后:19 个被自动处理完,5 个带原因上报(目录不存在),0 个变成无信息的失败。
19 这个数字值得拆开看:找不到脚本的 10 个里,6 个直接读日志得出结论,4 个在子目录里找到脚本;脚本返回 4 的 5 个和返回 2 的 4 个,全部靠 read 日志收尾;剩下的就是原本就正常的 6 个。
5 个上报的也没浪费。它们给出的结论是「目录不存在,需要人工确认路径」——这不是能力不足,是正确行为。人接手只需要改一个配置,不需要重新排查一遍。
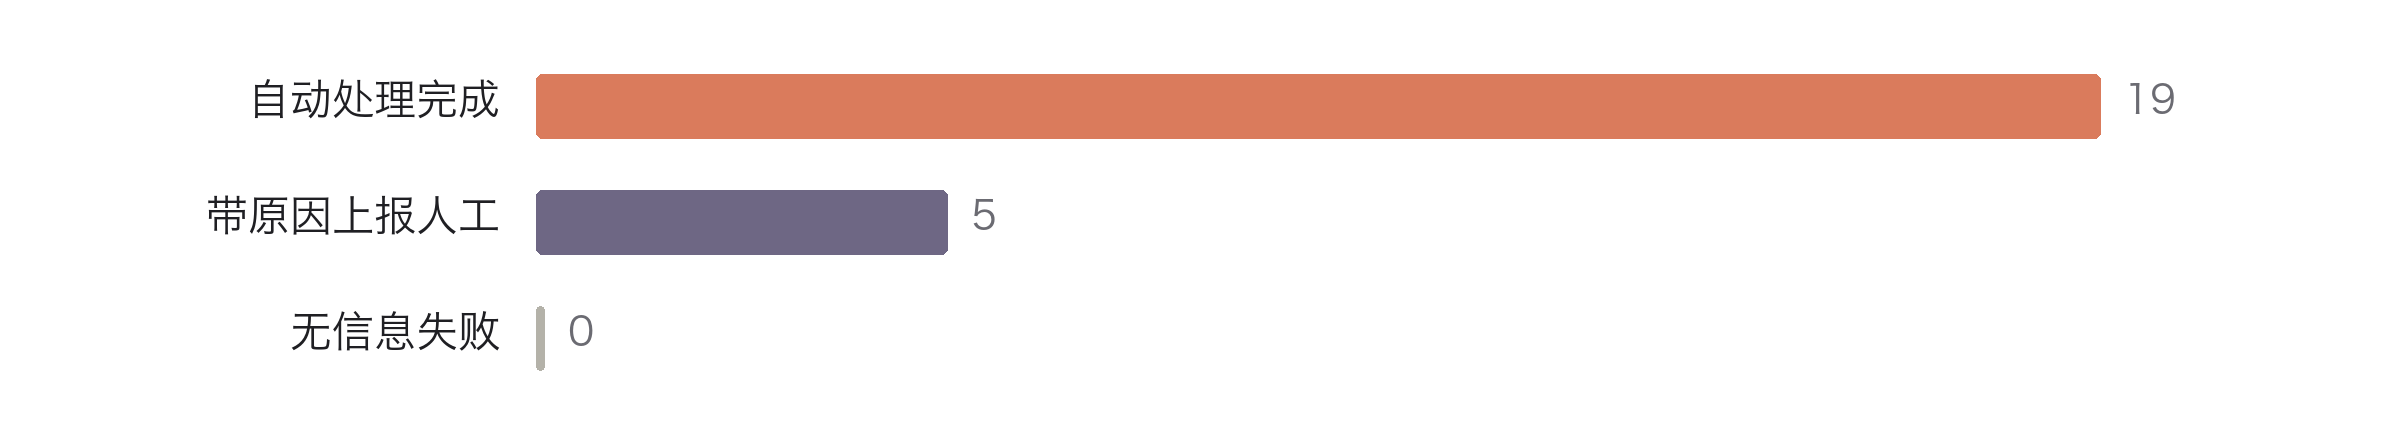
24 个失败任务改造后的去向:19 个自动处理完成,5 个带原因上报人工,没有任何一个落在「无信息失败」。
成本侧也要说清楚。脚本式跑 30 个任务花了 30 次子进程调用;循环式花了 63 次工具调用,平均每个任务 2.1 次。多出来的调用就是探索成本——ls 一次、read 一次,然后才动手。
这笔账划不划算,取决于失败一次的代价。如果失败意味着一个人工介入、一次重跑、一次客户投诉,那多两次工具调用完全不值一提。如果任务本身极其简单、失败率本来就接近零,那确实没必要上循环。
迁移顺序:先并跑,再切换
不要一次性切。第一步让两套并行跑同一批任务,只记录不切换,对比结论是否一致、循环式的额外成本有多少。这一步通常能暴露出脚本里那些没人知道的隐式约定。
第二步挑一类任务真切换,选失败率最高但影响面最小的那类。跑一两周,看人工介入率的真实变化。
第三步才是全量。这时候你已经有了真实的对照数据,也有了「它什么时候会出错」的直觉。
有一件事必须提前做:把脚本的退出码语义整理成文档。你会发现有几种码连原作者都说不清含义。这些是迁移路上最硬的部分,跟框架无关。
最后一篇讲上线之后。框架能保证失败信号送达模型(实测 20 条用例全部送达),但它不保证模型判断正确、不保证成本可控、不保证线上可回滚。这些是你要自己搭的。
引用与来源
- 本系列第 1 篇:30 个任务的对照实验 — 同一任务集的原始数据
- pi-agent-core:工具与钩子 — 核对 2026-10-31