这篇按源码核对了 LoopForge 的十四章:先说它解决什么,再给与容器编排、流水线、Agent 运行时的对照,然后拆状态流转、两套运行时、凭据与信任边界、验证与成本口径,最后给反面意见和常见问题。核心结论是,这套系统的复杂度集中在租约、门禁终态、凭据边界和失败恢复,不在调用模型;值钱的是把不确定的输出变成可签字的交付记录,而不是画布或模型能力。
LoopForge 是腾讯开源的自托管交付编排系统,把 10 种编程 CLI 收进带沙箱、人工审批与运行留痕的 SOP,解决的是团队交付的可重复性。它不提升模型能力,只约束模型外面那层交付过程。SOP 在这里不是文档,是一张可执行的图:节点由 Agent、脚本、人工关口和子流程组成,每次运行冻结一份快照,产物、日志、工具轨迹和签字记录都留在自己的环境里。仓库在 2026 年 7 月 28 日创建,11 月 15 日仍在提交,1295 个 Go 文件里有 783 个测试文件;真正复杂的地方不在调用模型,而在租约、状态机、凭据边界和失败恢复。读它最该带走的不是又一个 AI 工具的名单,而是一套把不确定的模型输出收敛成可验收状态机的工程做法。


数据截至 2026-11-15,核对对象为 github.com/Tencent/LoopForge 的 main 分支浅克隆(最新提交 dd56585,2026-11-14)与 GitHub 公开接口。仓库规模数字统一按排除 web/ 目录的 Go 源码统计:1295 个文件、269,672 行,其中 783 个测试文件、136,309 行;路由次数只数 internal/httpapi 下非测试源码。凡引用验证结果,均注明原始记录日期与适用范围,不把历史快照当作当前版本的认证。
它解决的是「一次运行」不等于「一次交付」
让一个编程 Agent 修一个 Bug,最容易出问题的地方不是它写不出代码,而是没人能说清这一轮到底做了什么。方案可能被跳过,测试可能被忘记,实现和评审可能由同一个上下文完成,跑到一半停了也没有人发现。演示一次很顺,团队按周交付就不行:下一次运行是另一套行为,上一轮的结论无法复用,出了问题也拿不出证据。
LoopForge 的中文 README 把这个痛点写得很直白:让编程 Agent「修一下这个 Bug」,结果往往取决于这一次的运行。它给出的答案不是换更强的模型,而是在模型外面加一层固定的交付结构。一条被验证有效的做法被存成 SOP(标准交付流程,这里指一张可执行的节点图),下一个需求按同样的方式走,评审和验收都在流程里,而不是靠人盯着聊天窗口。
这层结构由三个抓手组成。第一是角色分离:方案、实现、评审、测试各有独立的提示词、执行器、模型、规则、技能包和 MCP 工具,同一个角色既能在流程里当节点,也能在对话里被当作子 Agent 调用。第二是确定性优先:构建、测试、静态检查、生成报告这些不需要智能的步骤用 Shell 或 Python 脚本节点,不把 AI 塞进每一格。第三是人在回路:关键节点设人工关口,看完报告再放行,或者打回到指定环节返工。三者叠加之后,「这次跑得怎么样」变成「这条流程在第几个节点、以什么证据、由谁签字」。
产品给了两种工作方式,它们不是新旧版本,而是同一套需求上的两种入口。探索、快速修复、和 Agent 反复迭代用对话;阶段固定、需要签字确认的可重复交付用流程运行。对话里 Main Bot 按需打开一个带项目仓库的 Docker 工作区,把项目角色当子 Agent 调用,最后提交 PR 或直推共享分支;流程运行则由引擎按节点顺序执行,每次运行有独立沙箱和独立记录。
两种工作方式的边界
| 对比项 | 与 Main Bot 对话 | 运行 SOP |
|---|---|---|
| 适合 | 探索、快速修复、反复迭代 | 阶段固定、需要签字确认的可重复交付 |
| 谁来决定下一步 | Main Bot 按当前消息判断 | 引擎按冻结的图与依赖自动推进 |
| 人怎么把控 | 中途排队或引导消息,暂停、恢复、接管正在运行的流程 | 在人工关口审批,打回指定环节,从任意节点重试或重跑 |
| 交付物 | PR 或直推合入共享分支 | 文档、代码或 PR,外加每个节点的产物与日志 |
| 运行记录 | 会话消息、工作区快照、关联的交付记录 | 节点状态、工具轨迹、Worker 日志、产物快照、工作区预览 |
依据 README.zh-CN.md「两种工作方式」与 docs/conversation-workspaces.md 整理。两者共享同一套需求记录,不是两套割裂的系统。
真正把两条路径缝在一起的是「需求」。无论改动来自对话还是流程运行,都能追溯到原始需求,并计入交付与成本统计。对话里 Main Bot 识别出明确需求时,会在打开工作区时提交需求标题与描述;提交 PR 时若工作区还没关联需求,优先复用会话已关联的未完成需求,否则按 PR 标题创建。反过来,流程运行的需求只在派发时确定。对话工作区在统计上不算一次 Run,它的 Token 和成本计入总量与趋势,但不计入运行数、成功率和平均耗时——这个切分很关键,否则「对话改代码」会把研发效能指标搅乱。
还有一个容易被略过但很说明设计取向的细节:新注册账号会自动加入体验项目,里面那条「平台验收 · 脚本与审批」流程只有三个节点——一个真实 Shell 脚本生成报告、一个人工审批、一个收尾脚本。它不需要任何模型密钥。也就是说,团队被要求先把「流程能不能走通、审批能不能落地、产物能不能留存」验证完,再谈接哪个模型。这个顺序在多数 AI 工具里是反过来的。
仓库公开状态(2026-11-15)
| 指标 | 数值 | 说明 |
|---|---|---|
| Star 数 | 1,163 | GitHub 接口,2026-11-15 读取 |
| Fork 数 | 248 | 同一时点 |
| 开放 Issue / PR | 72 | 页面显示 35 个 Issue + 37 个 PR |
| 提交数 | 324 | main 分支,GitHub 接口分页末页 |
| 发布版本 | 13 | v0.1.0 到 v0.3.9-rc.1 |
| 贡献者 | 16 | 含依赖机器人,GitHub 接口 |
要点:这类产品真正的用户不是「想让 AI 写代码的人」,而是「要对交付签字的人」。前者关心这一轮回答好不好,后者关心同一件事做一百次是不是一百个样子、出事时能不能查到是谁在哪一步放行的。LoopForge 所有看起来笨重的设计——冻结快照、产物契约、必交的节点终态、人工关口——都是给后一个问题准备的。
把这一点想反了,就会把项目误读成「又一个带画布的 Agent 平台」,进而在选型时拿它和聊天界面比体验、和模型比效果,得出完全错位的结论。
先给对照表:它放在你已有技术栈的什么位置
新概念最省事的讲法是先找已做过的东西做锚点。LoopForge 里的每个主要部件,都能映射到容器编排、流水线、Agent 运行时或上下文装配里熟悉的位置;差别都在「它为什么不能直接用原来那套」。下面这张表先把位置摆正,后面几章再逐个拆。
与已有技术的映射
| LoopForge 里的东西 | 大致相当于你已经做过的 | 解决什么问题 | 关键差别 |
|---|---|---|---|
| SOP 节点图 | LangGraph 的 DAG / CI 流水线阶段 | 把一次交付拆成可复用的步骤 | 节点里有非确定性的 Agent,边只在成功时推进,还要能被打回上游重做 |
| 引擎租约与实例接管 | K8s controller 的 lease / Swarm 任务调度 | 多实例下同一条运行只被一个实例推进 | 30 秒租约落在 MySQL,靠执行代次区分新旧执行,旧执行的结果会被丢弃而不是覆盖 |
| Docker 沙箱工作区 | 容器化执行环境 / K3s 里的临时 Pod | 让每次运行拿到干净、可复现的代码环境 | 工作区路径要在宿主机和平台容器里保持同一个绝对路径,沙箱由宿主机 Docker 守护进程起兄弟容器 |
| 角色定义 | RAG 的上下文装配 / Skill 与规则集 | 把提示词、模型、工具、产物要求绑成一个可复用实体 | 角色还绑定执行器、规则、技能包、MCP 与产物契约,且流程节点与对话子 Agent 共用同一份 |
| 人工关口 | 流水线里的手动批准步骤 | 在关键节点让人看完证据再放行 | 可以拒绝并打回指定节点、补充信息重跑、从任意节点重试,不是单纯的一键继续 |
| 门禁终态提交 | 测试报告 / 质量门禁的通过信号 | 逼 Agent 给出可判定的结论 | Agent 必须调用工具提交 pass、rework、fail 或 human,只输出一段报告不算节点完成 |
| 运行快照 | 不可变发布产物 / 事件溯源 | 让后续编辑不影响在途运行 | 流程定义、沙箱配置与预览契约在创建时冻结,改模板不会改到正在跑的那次 |
| 按人绑定的凭据 | 服务账号 / RBAC 权限模型 | 让模型调用和 Git 操作归属到具体责任人 | 模型密钥、Git 密钥随需求责任人走,团队共享密钥有明确白名单且不覆盖定时任务 |
映射依据 docs/architecture.md、internal/domain/workflow.go、internal/engine/parallel_exec.go、internal/engine/gate_submit.go 与 docs/deployment.md。
有三处差别值得单独拎出来,因为它们决定了「能不能拿现成系统改」。第一,图的边目前只声明成功条件,失败与返工不是靠另一组边表达,而是靠节点上的拒绝目标、最大尝试次数、最大返工轮次和人工动作接口共同决定——这是流水线式状态机,不是通用有向图引擎。第二,Agent 节点的结果不可判定:一段自然语言报告无法被下游机器消费,所以项目要求 Agent 通过 MCP 工具提交结构化终态,附带 reason、行动要求、发现项与证据,并对字段长度做硬限制。第三,人工关口不是流程外的评论区,它是运行状态的一部分,拒绝动作会真实改变节点状态和后续调度。
与同类产品的差别
| 对照对象 | 它做什么 | LoopForge 多出来的一层 |
|---|---|---|
| Dify / n8n / Flowise | 通用 AI 或自动化工作流搭建 | 角色分工、带真实仓库的 Docker 沙箱、GitHub 交付、人工验收关口与运行证据 |
| 直接跑 CodeBuddy / Codex / Claude Code | 单个 CLI 完成读代码、改文件、跑命令 | 谁来做、在哪个沙箱、按什么顺序、经过哪些检查、由谁签字 |
| Jenkins / GitLab CI 一类流水线 | 确定性的构建、测试、部署 | 步骤里嵌非确定性 Agent,并让它的输出变成可验收的结构化结论 |
| 多 Agent 框架 | 编排模型调用与工具链 | 把编排结果持久化成团队可查、可审计、可复跑的交付记录 |
前两行来自仓库 README 的常见问题自述,后两行是按代码实现做的归类。
README 自己回答「和 Dify、n8n、Flowise 有什么区别」时,落点是「专注用编程 Agent 做软件交付」。这个说法准确,但还不够狠。真正把 LoopForge 和通用工作流平台分开的,是它把「不确定的输出」当成必须被约束的对象:产物契约写明节点该交出什么文件,脚本节点校验文件真实内容,门禁工具逼 Agent 交出终态,人工关口再对证据签字。整条链路的目标是收敛,不是编排本身。
所以更准的类比是 CI/CD,不是工作流搭建器。CI 的价值从来不是「能跑命令」,而是「每次提交都按同一套检查走、失败有明确位置、记录可回溯」。LoopForge 把这套思路搬到了 Agent 参与的软件交付上,只是把「编译不过」换成了「没交产物、门禁没提交终态、评审发现阻断问题」。理解了这个位置,后面看到租约、执行代次、工作区快照这些偏基础设施的代码,就不会觉得是过度设计。
术语在这里收一下:SOP 是「标准交付流程」的缩写,在这套系统里特指存成版本化定义、由引擎执行、每次运行生成独立快照的节点图;它解决的是「同一类需求怎么每次都按同一套检查和签字交付」,类比是 CI 里的流水线定义,位置在 internal/domain/workflow.go 的 WorkflowDefinition 与 internal/engine 的执行循环。后面提到「流程」「SOP」「运行」时,分别指定义、模板与某一次具体执行,不混用。
要点:把它当成「Agent 外面的交付操作系统」,比当成「Agent 编排框架」更少踩坑。框架关心怎么把一次调用串起来,操作系统关心多任务怎么隔离、谁占着资源、崩溃后谁接管、事情做完留了什么证据。LoopForge 的代码重心明显在后者:编排逻辑只有三万多行,处理和约束执行环境的代码是它的数倍。
五层架构:从进程入口到数据库,谁负责什么
仓库的 docs/architecture.md 只有 21 行,却把最重要的事实放在第一句:平台保留上游的 Go module 名 agentflow、包边界和 AGENTFLOW_ 环境变量前缀,目的是减少持续合并冲突。这句话基本定下了整个仓库的气质——它不是从零设计出来的开源项目,而是一个内部系统被裁成公开版之后留下的形状。看架构要带着这个前提。
分层结构(按目录职责整理)
  浏览器 / 对话工作台 / 流程设计器        web/  chatbot/
            |  HTTPS + SSE + MCP
  +---------------------------------------------------+
  | 接入层   internal/httpapi   147 个非测试文件      |
  |          443 处路由方法注册,按领域拆 handler     |
  +---------------------------------------------------+
            | 领域 Repo(15 类,显式指针注入)
  +---------------------------------------------------+
  | 编排层   internal/engine    34,243 行            |
  |          SOP 图 / 30 秒租约 / 并行分支 / 产物    |
  |          internal/schedule  定时扫描与派发        |
  +---------------------------------------------------+
            | Runner 协议(控制连接 + 任务回执)
  +---------------------------------------------------+
  | 执行层   internal/runtime   34,278 行            |
  |          internal/runner    12,905 行            |
  |          执行器协议 / 私有 HOME / 沙箱 / 快照     |
  +---------------------------------------------------+
            | gorm + 手动 SQL 迁移(36 份)
  +---------------------------------------------------+
  | 存储层   MySQL 8.4         internal/repo         |
  |          runs / leases / artifacts / telemetry    |
  +---------------------------------------------------+
  cmd/agentflow(api|worker|all)· agentflow-runner
  agentflow-mcp · agentflow-gate-mcp · loopforge-account
目录职责与代码体量
| 目录 / 入口 | 职责 | 可核验事实 |
|---|---|---|
| cmd/agentflow | API、Worker 或合并进程 | 保留 -role api / worker / all 三种角色 |
| cmd/agentflow-runner | 个人与池化执行机器 | 独立二进制,绑定码短期有效 |
| cmd/agentflow-mcp / -gate-mcp | 公共 MCP 与结构化门禁结果 | 门禁结果由工具提交,不由文本解析 |
| internal/engine | SOP 图、租约、调度、沙箱生命周期与交付 | 34,243 行,含 134 个文件 |
| internal/runtime + runner | 执行器协议、凭据、隔离、产物 | 合计 47,183 行 |
| internal/httpapi | HTTP 与 MCP 处理器 | 102,985 行,147 个非测试文件,443 处路由方法注册 |
| internal/repo | MySQL 持久化,一领域一 Repo | 35,647 行;代码只做增量 DDL |
| migrations/ | 显式数据迁移与公开目录种子 | 36 份 SQL,应用启动不自动执行 |
| local/ | 本地工作流与宿主集成 | 两套独立实现,Classic 与 Portable |
| web/ + chatbot/ | 内嵌工作台、偏好与登录 | 设计约定集中在根目录 design.md |
行数按排除 web/ 目录的 Go 源码统计,含测试文件;目录之间不重叠,可横向比较。
各包代码行数
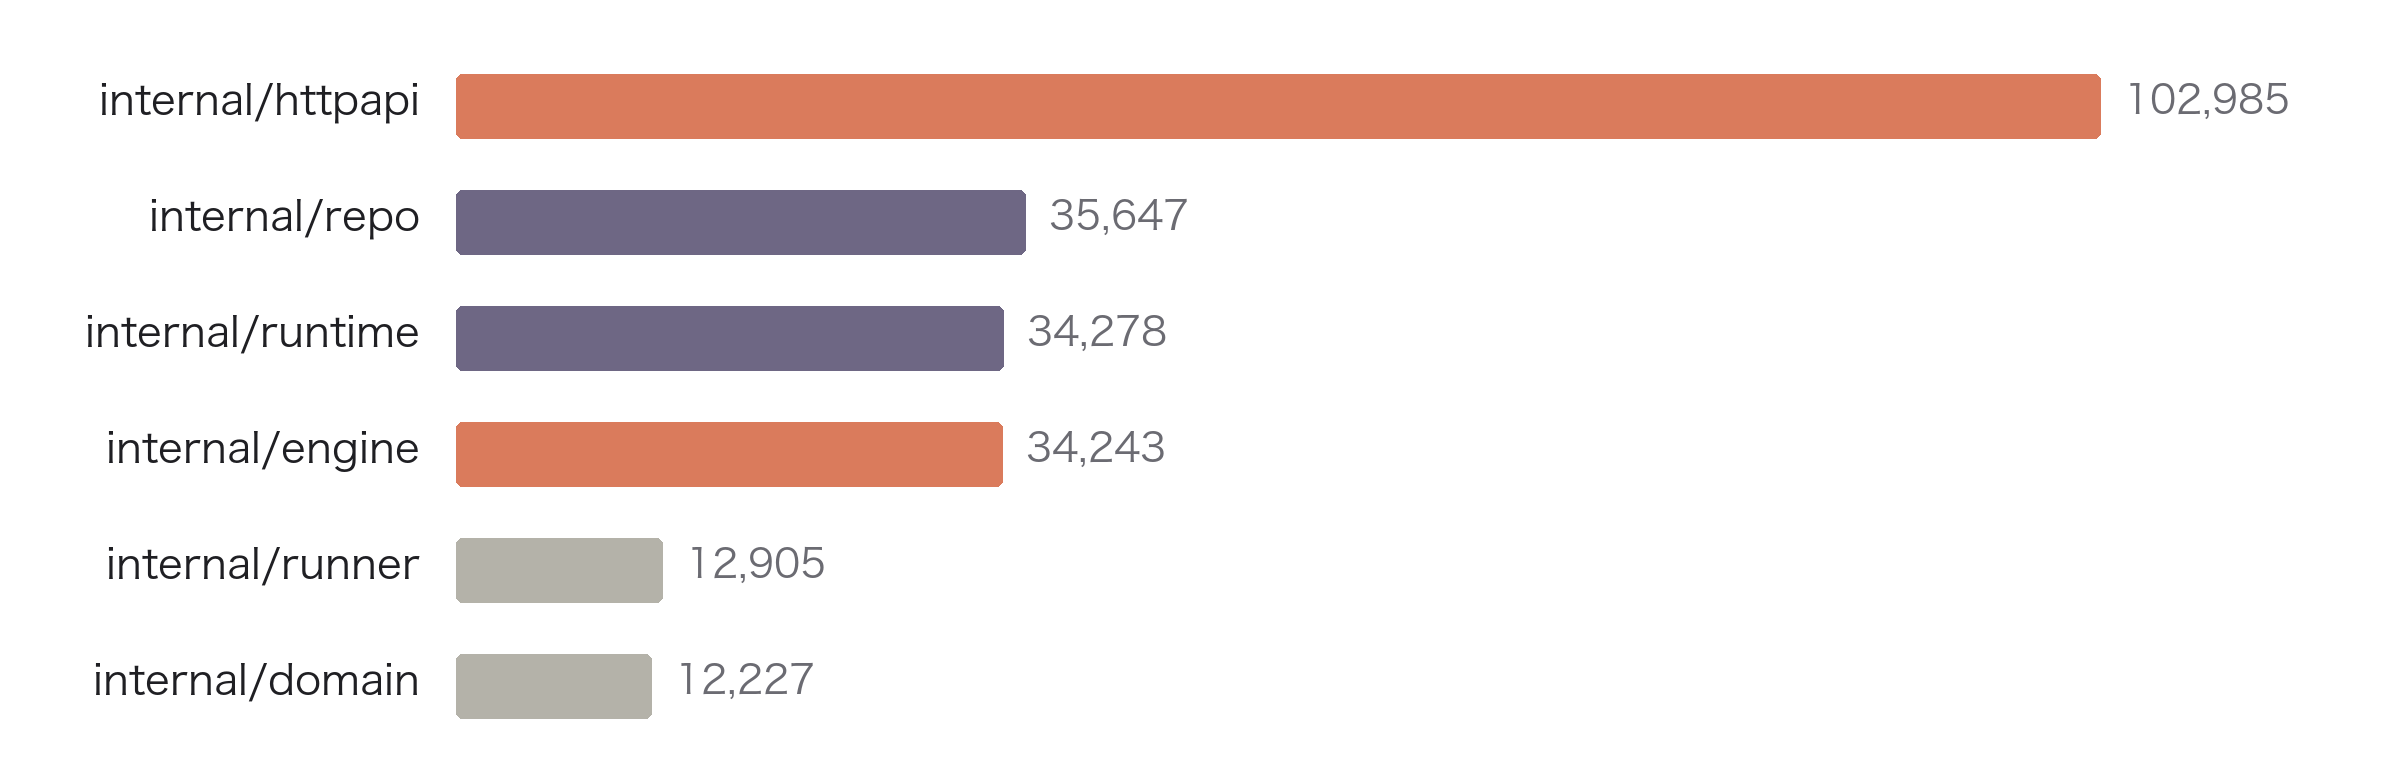
主要 Go 包的代码行数(含各自测试)。接入层最大,说明这套系统的复杂度大量落在权限、接口与状态协调上,而不是 Agent 调用本身。
仓库语言构成
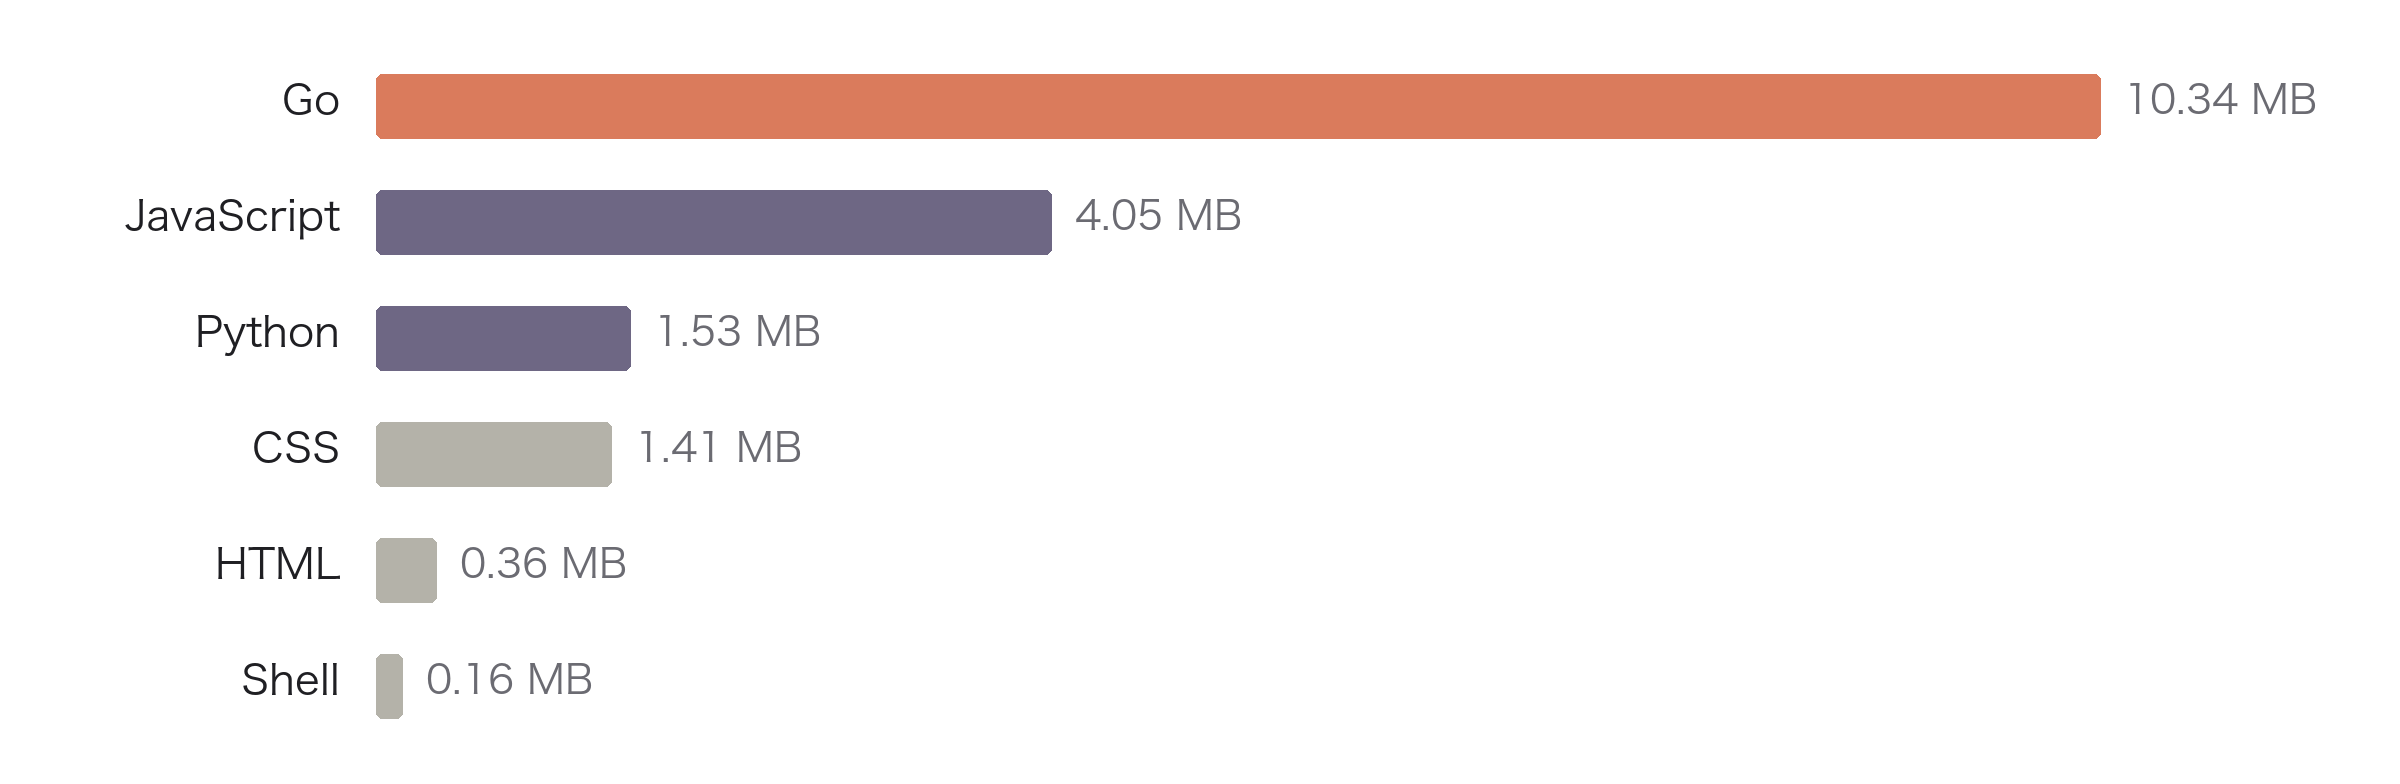
GitHub 语言统计接口返回的源码字节数,反映仓库里嵌入式前端与脚本资产的规模。Go 是主语言,但 JavaScript、CSS 与 HTML 合计接近六百万字节,对应内嵌的 Web 工作台。
两个图表放一起看会得出一个和直觉相反的结论:一个主打「编排编程 Agent」的项目,最厚的包是 HTTP 接入层,不是引擎。原因不神秘——只要系统要支持多实例、多项目、多执行机器、浏览器实时流、审批、产物下载、外部用量上报和权限校验,接口与状态协调的代码量必然远超调度算法本身。internal/httpapi 一个包十万行,是 internal/engine 的三倍;把这类项目估成「写个 DAG 调度器」会严重低估落地成本。
另一处体现内部血统的是命名。Go module 仍叫 agentflow,环境变量仍以 AGENTFLOW_ 开头,公开版文档里也能看到 gongfengProjectId 这类兼容字段,远程 GitHub 仓库身份用 github: 前缀区分。docs/open-source-scope.md 说得更明白:遗留的组织内 tracker 与认证协议代码作为可选兼容层保留,Web 入口默认隐藏;公开版默认不装企业 MCP,也不连内部身份与市场服务。做二次开发时,这些字段不是可以顺手删的垃圾,它们是与上游持续同步的接缝。
包边界也有硬约束。根目录 AGENTS.md 规定:internal/repo 下每个领域一个 Repo,禁止在 Store 上新增领域方法,一个文件不得为其他领域定义方法;internal/httpapi 同理,新领域必须新建 handler,Server 只保留服务级端点;代码不做数据迁移、不做种子数据,基线 schema、改数据与 seed 一律写成 migrations/ 下的 SQL 由运维手动执行。文档还列出 2026 年 9 月的一次整改记录:把散落的自愈逻辑、模板 CRUD 与管理员初始化从代码里清掉,只保留测试专用的默认数据。这类规则通常出现在多人长期维护的大仓,不是新项目的写法。
要点:架构上最值得抄的不是分层,而是「代码不做数据迁移」这一条。把 schema 演进从应用启动路径里彻底拿掉,代价是升级要人工核对并执行脚本,收益是任何一次进程重启都不会偷偷改写生产数据。对需要私有化交付、客户环境不可随意重启的系统,这个取舍比多加几个自动化特性值钱。
反过来说,它也让升级变成运维动作:docs/deployment.md 专门把 36 份迁移分成「安装器已覆盖」「升级必须跑一次」「只回填历史数据」三类,漏跑会在打开运行详情时遇到缺列报错。这不是缺陷,是设计选择的账单。
一次 SOP 的状态流转:从启动到签字,中间会断在哪
看这类系统最容易犯的错,是只看画布上那几个方框。真正决定它能不能用在团队里的,是方框之间那些「出事之后怎么办」的路径:节点跑一半被别的实例接管、Agent 交了一段漂亮报告却没交结论、人在审批时打回上游、工作区被回收后又要重跑、流程模板在运行时被改了。LoopForge 把这些路径都写进了代码,而且写得比正常路径细。
启动是一次短调用。POST /api/runs 只负责创建长任务并立刻返回,不等待完成;接口文档还提醒,保存为需求的工作应优先走需求派发,以便建立任务与需求的关联。运行创建时会把流程定义、沙箱配置和预览契约冻进 workflow snapshot,后续编辑模板不会改到在途运行。这个「冻结」在 internal/domain/workflow.go 里有明确注释:沙箱快照只在运行的 workflow snapshot 上填充,目的是让重试能在目录定义变更后重建原来的环境;流程指标分类与角色链标签也随快照冻结,历史执行不受后续编辑影响。
一条运行的骨架与分支
  POST /api/runs ──> 创建 Run + 冻结三份快照
        │            流程定义 / 沙箱配置 / 预览契约
        v
  依赖就绪的分支 ──并行──> 各自 executeNode(独立 goroutine)
        │                     ├─ 锁 (run,node) 防同节点重入
        │                     ├─ 锁 (workspaceOwner,agent) 防同角色争用
        │                     └─ 锁 (runID) 保证一次只绑一台机器
        v
  节点执行 ──> Agent / 脚本 / 子流程 / 预览构建
        │
        ├── pass ──────────────> 下游节点
        ├── rework ─(有 rejectTo)> 打回指定上游,重做
        │           └(无目标) ─> 降级为 fail
        ├── fail ──────────────> 终态失败,不打回
        └── human ────────────> 暂停,进入待我确认
                                   │
               approve / reject / retry / pass / cancel
                                   v
                        继续下游 或 从任意节点重跑
并行不是把整条运行串行锁住。internal/engine/parallel_exec.go 的文件头注释写得很清楚:平行分支各自跑独立的 executeNode,不再有「整条运行一把锁」,改成三把更窄的按 key 加锁。第一把锁是「同一运行的同一节点」,因为暂停后恢复、返工、租约接管都可能在上一次执行还没收尾时重新起一个节点,新执行必须等;第二把是「同一工作区拥有者下的同一角色」,因为 Agent 的控制目录、私有 HOME、门禁配置都按角色 ID 索引,同一次检出里两个同角色节点(包括父流程里的子流程)要排队;第三把是「同一运行的机器池绑定」,保证并发的起始节点挑到同一台机器。锁表用引用计数,运行结束后删条目,不留 mutex。
更细的一处是 reconcileNodeExecutions:它先把本实例在跑的执行注册表拷贝一份,再去读库里的节点状态,顺序不能反。注释解释了原因——执行只有在提交 running 状态之后才注册,所以「先拷贝再读状态」保证读到的状态不会比注册表更旧;反过来做,会让刚好在两者之间启动的节点被误判成过期而取消,库里却留下一个永远 running 的节点。被判定不再属于当前尝试的旧执行会被 cancel,它的结果本来也会被丢弃,取消是为了尽快释放节点锁让新尝试开始。这种对时序的较真,是分布式状态机里最容易被省略、也最容易在生产里变成幽灵任务的部分。
节点的「完成」也不是靠模型说一句「我做完了」。门禁结果由 Agent 调用 MCP 工具提交到工作区里一个固定路径的 JSON 文件,引擎再读取解析。internal/engine/gate_submit.go 里能看到完整约束:终态只能是 pass、rework、fail、human 四种;reason 必填;选 human 时必须给出 actionRequired;reason、行动要求、摘要各不超过 4000 字,发现项不超过 50 条,标题不超过 500 字;解析失败、终态非法、字段超限都会直接报错。appendSubmitGateInstruction 还把这段要求拼进节点提示词,并明说「不要用报告文本或最终回复代替工具调用」。如果一次没交,重试时的提示词变成更硬的一句:不要重复执行任务,立刻提交终态。
四个终态在引擎里各有去处。pass 正常流转;rework 依赖节点上配置的 rejectTo,没有目标时会降级成 fail,并给出「节点没有返工目标」的错误,避免报一个误导性的「上游返工」;fail 直接标记失败;human 暂停等人。这套设计把「Agent 觉得自己做完了」和「引擎认为这个节点完成了」彻底分开,也是整篇文章里最值得单独记住的一条工程判断。
人工动作接口
| 人工动作 | 接口 | 能做什么 | 边界 |
|---|---|---|---|
| 批准 | /approve | 放行等待中的关口 | 与需求关联且交付锁定时返回 409 |
| 手动通过 | /pass | 把已失败的脚本节点视为通过并继续 | 仅脚本节点;Agent 节点不能手动通过 |
| 拒绝 | /reject | 按 targetId 与流程策略打回上游 | 要带原因,例如缺少回归测试 |
| 重试 | /retry | 重跑指定节点,可附补充上下文 | 工作区需恢复时返回 202,异步轮询后再提交 |
| 拒绝建议 | /decline-retry | 拒绝引擎给出的重试建议 | 只影响建议,不改变节点状态 |
| 取消 | /cancel | 取消整条运行 | 空请求体即可 |
依据 docs/api/orchestration.md「人工动作」一节。成功均返回 ok,状态不符通常返回 400。
重试路径里还藏了一个很实际的问题:工作区可能已经被回收,恢复要花时间,不能让 HTTP 请求干等。带 Prefer: respond-async 的重试会先返回 202 和一个 restoring 状态,页面轮询 /workspace/restore 直到 ready,再重新提交原来的重跑请求;只有第二次拿到 200 才算重跑已启动。请求可以带 expected 字段写上期望的节点状态、尝试次数和返工计数,防止恢复期间节点已经变化时重跑一个过期的尝试。页面关闭只继续已被受理的恢复,不会自动替用户发起重跑。这套「恢复与动作分离」在长任务系统里是标配,但很多自研系统会把它省掉,然后用一个越来越长的超时硬扛。
租约是另一条暗线。internal/engine/engine.go 里默认 leaseTTL 是 30 秒,运行记录里带 ownerInstanceId、leaseUntil、executionGeneration、workspaceHost 和 workspaceRoot,接口文档明确告诉客户端这些是内部定位信息,别拿去做实例接管。MySQL 上的并发抢占与租约恢复有专门用例 TestSOPHandoffMySQLConcurrentClaimsAndLeaseRecovery,验证记录里说它在独立的一次性数据库上跑过。工作区租约则按「轮」持有:一轮里工具调用复用并持续续租,只在轮次结束或切换工作区前保存完整快照;切换完成后旧工作区解绑,空闲回收不再等一小时,而是在下一次扫描保存兜底快照后回收。删除会话会把它开过的所有工作区一并删除,借用的 SOP 工作区不受影响。
内置流程的节点构成
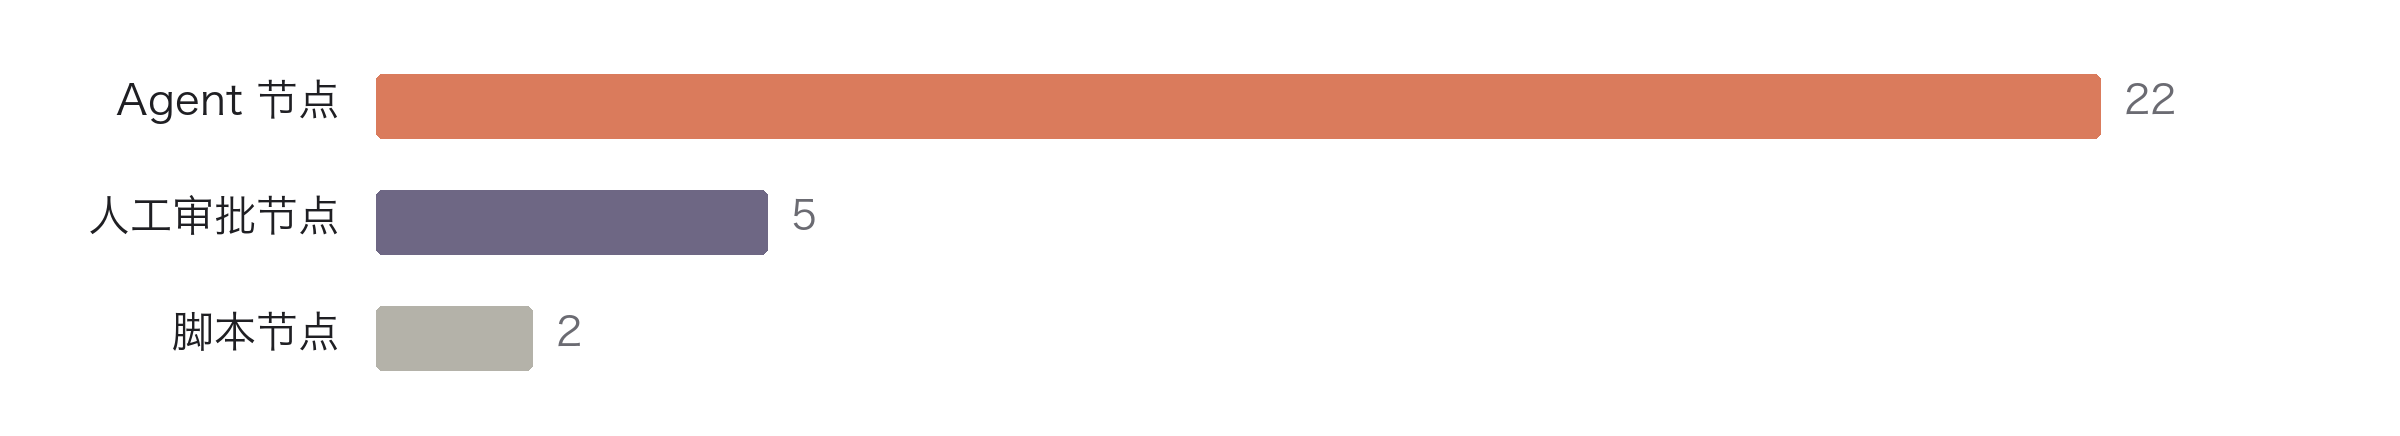
仓库 migrations/seed 里内置流程的节点类型分布。四条通用模板各带一个人工验收关口,平台验收流程则由两个脚本节点夹一个审批节点组成,专供无模型凭据时跑通链路。
把 29 个内置节点摊开看,比例本身就是产品判断:22 个 Agent 节点、5 个人工审批、2 个脚本。四条通用交付模板分别是通用后端、通用前端、通用缺陷修复、通用产品方案,前三条各 7 节点(需求定型、方案设计、开发实现、独立评审、测试验证、人工验收、交付汇总),产品方案 5 节点(少了编码与测试),验收流程 3 节点。每个 Agent 节点都声明了必交的产物文件,从 requirement.md 到 delivery.md,形成一条文档链;人工验收节点上写着 rejectTo 指向实现或设计节点,拒绝后直接打回。角色提示词里还有一句共同的硬约束:不得伪造通过结论,发现阻断问题必须明确写出 REJECT。
值得留意的是,这些模板里真正跑命令的确定性步骤并不多,测试验证也交给 Agent 节点完成。项目确实支持脚本节点并强调「不需要 AI 的地方就不用 AI」,但内置蓝图选择让 Agent 去执行项目真实测试并要求它把命令、退出码、未验证范围写进报告。这是一个取舍:换了更强的可移植性(不用为每个项目预置测试命令),代价是「测试是否真的跑过」依赖一个可复核的报告文件和后续人工关口。验证记录里那次四角色 Python 交付之所以被反复引用,正是因为最终脚本重新跑了测试并比对了被验收代码的哈希,把这份信任闭环补上了。
要点:这一章最该带走的不是流程图,是两条否定的设计:旧执行的结果必须被丢弃,Agent 的结案陈述不能算节点完成。前者解决多实例下「谁说了算」,后者解决「非确定性输出怎么被机器消费」。少了任意一条,界面再漂亮也只是个能跑 Demo 的玩具。
对自研同类系统的团队,还有一个可抄的小细节:把恢复和动作拆成两次请求,并让动作请求带上期望状态。它把「页面关了怎么办」「恢复期间状态变了怎么办」两个问题从超时参数里拿出来,变成明确的协议。
平台版与 Local 是两套运行时,不是大小号
README 里有一句很容易被滑过去的话:平台 SOP 导出后在本地独立执行是后续方向,尚未实现。这句话划开了一道明确的边界。很多人看到 LoopForge Local 会自然理解成「平台版的单机精简版」,实际上 local/ 目录里是另一套完整实现,它和平台版共享的是流程语义与产物契约,不共享运行时。
Local 面对的场景是:个人开发者不想部署服务端,只想在当前 IDE 或 CLI 里用内置的交付流程。安装命令是在目标项目里执行 npx 安装到指定宿主,然后在宿主里运行斜杠命令启动流程。它依赖 Node.js 20 以上、Python 3.8 以上和一个编程助手,不需要 Docker,不需要 MySQL,也不需要账号体系。平台版则是团队共享的对话工作区、可视化流程画布、审批、运行记录与指标。
两套运行时的对照
| 维度 | 平台版 | LoopForge Local |
|---|---|---|
| 状态存在哪 | MySQL 的 Run 与 nodes 映射,租约与执行代次 | 项目内 artifacts 下的 workflow-state.json |
| 谁推进流程 | Go 引擎按依赖自动调度 goroutine | 宿主 Agent 按提示词调用状态脚本,逐阶段 prepare / start / finish |
| 隔离怎么来 | Docker 沙箱容器 + 私有 HOME + 工作区快照 | 宿主提供的子 Agent 生命周期;没有就降级为单上下文 |
| 审批怎么落 | 人工关口节点 + 待我确认 + 运行控制接口 | 状态脚本的 approve 命令,需求阶段必须用户明确确认 |
| 证据留哪 | 运行详情、日志、遥测、产物快照、工作区预览 | artifacts 下的阶段报告与可选本地看板 |
| 失败怎么续 | 从任意节点重试、打回上游、工作区恢复后重跑 | resume 返回下一动作,状态文件不存在则要求重启 |
| 依赖 | Docker + Python 3 + MySQL + 平台服务 | Node.js 20+ / Python 3.8+ / 一个宿主 |
平台侧依据 docs/api/orchestration.md 与 docs/conversation-workspaces.md;Local 侧依据 docs/local/architecture.md、docs/local/editions.md 与 local/skills/devflow/references/workflow-contract.md。
Local 内部还分两个版本,而且互斥。Classic 是默认版,以 .codebuddy 目录为参考行为,.codex 是已有原生适配,.cursor 与 .claude 由生成脚本产出,四个目录都是完整宿主包,运行时不读 skills/devflow。Portable 版把 skills/ 当作唯一事实源,装到目标项目时才生成各家宿主的目录,逻辑角色、产物、规则和宿主能力分别由 manifest 管理,Cursor 与 Claude Code 共用的执行器正文只保留一份。安装器在每个项目里只允许同一宿主启用一种版本,避免两套工作流同时加载造成状态与产物冲突;安装计划与状态记录在项目的 .devflow 目录里,切换要用强制参数。
Portable 的运行时核心只有五个抽象操作:spawn 创建一个全新的真实 Agent 并拿回宿主签发的 ID,send 在不换身份的前提下补输入,wait 等待完成或结构化交接,close 释放,spawn_helper 起一个只读检索助手。文档用加粗语气禁止「用自造标签代替宿主返回的 ID」,也禁止协调者自己生成隔离阶段的产物。适配器按宿主能力选:CodeBuddy 用 Team member 拓扑且不得把普通 task 子 Agent 当阶段执行者,Codex 用 spawn_agent 那一组,Hermes 用 delegate_task 并只登记宿主返回的委托 ID。没有任何受支持的生命周期 API 时,必须先报告限制、记录降级原因,才允许退回单上下文。这一段是整个 Local 实现的骨架,也是它和「写一堆提示词让模型自己拆任务」最直接的分界。
流程合同则把状态机的细节钉死在文件上。完整流程使用 artifacts 下以任务短名命名的目录;规模判断按影响范围而不是代码行数——单模块、预计不超过 3 个文件、无接口或数据影响算小,跨模块或约 4 到 10 个文件算中,涉及接口、数据模型、迁移、架构或高风险发布算大。小流程走 PHASE-0 到 SOLO 再到 SUMMARY,中大流程固定经过需求、设计、实现、评审、测试、条件性的知识沉淀与汇总。需求阶段在自动和手动模式下都必须等用户确认需求报告,确认前不得创建设计 Agent;实现阶段每批最多 3 个计划任务;评审阶段阻断问题为零才能过,否则回到实现;测试阶段可以补测试但不得改生产代码,并要区分失败、阻塞和未运行。
最硬的一条在收尾:每次 prepare 会记录必需产物的基线,finish 只接受 prepare 之后新建或变化的产物,不能拿旧报告直接过门禁;汇总阶段会自动重新验证实际路由上所有已完成阶段及必需产物,不混用小流程与中大流程的合同。校验器阻断缺失章节、未填占位项、空内容、内容过少和关键语义错误,但明确不为标题样式或排版偏好增加门禁。这套「文件即状态、脚本即裁判」的做法,把一个原本靠模型自觉的流程变成了可检查的合同。
要点:Local 不是平台版的缩水,而是把同一套编排契约编译成了提示词、状态文件和一个只依赖 Python 标准库的裁判脚本。它的强项是零部署、跟宿主能力走;弱项也很清楚:证据散在项目目录里,没有跨人、跨运行的统一审计视图,也没有平台侧的租约与实例接管。
选型时别把两者放在一条「功能多少」的轴线上比。个人在 IDE 里要的是低摩擦,团队要的是可追溯;当流程需要多人签字、需要复跑历史运行、需要把成本归到人和需求上时,Local 的产物目录撑不住,而这个缺口目前没有官方的导出通道。
10 种执行器,以及凭据、地区与风控的真实边界
LoopForge 不自己训练模型,也不替代编程 CLI。它把 10 种执行器接成可插拔的后端:CodeBuddy、Codex、Claude Code、OpenCode、Cursor CLI、Antigravity、Kimi Code、Pi、DeepSeek Harness 和 ZCode。每个 SOP 角色都能独立选执行器与模型,内置角色默认 CodeBuddy;对话工作台也按会话选执行器、模型和确认模式。这个数字不是营销口径,README 有一张按凭据与安装方式逐行列出的表。
十种执行器的接入差异
| 执行器 | 凭据来源 | 安装方式 | 使用边界 |
|---|---|---|---|
| CodeBuddy | 个人密钥,或管理员配置的平台共享密钥 | 镜像内置 | 澄清、通知汇总、Bot 回复与运行评测固定走它 |
| Codex | 个人密钥;已连接的执行机器可用本机登录 | 镜像内置 | SOP 沙箱里需放开自带沙箱限制 |
| Claude Code | 个人密钥;已连接的执行机器可用本机登录 | 首次使用从 npm 安装并缓存 | 镜像不内置,专有包首次用才装 |
| OpenCode / Kimi Code / Pi | 仅个人密钥 | 首次使用从 npm 安装并缓存 | 每次运行重建私有 HOME 配置 |
| DeepSeek Harness | 仅个人密钥 | 镜像内置 0.2.2-rc.1 | 装包与回复长度都有专门适配 |
| Cursor CLI / Antigravity | 仅个人密钥 | 首次在对话中由厂商脚本安装 | 不装进 SOP 沙箱 |
| ZCode | 仅个人密钥 | 需装到服务或执行机器的 PATH | 无独立 npm 包,缺了明确报错 |
依据 README.zh-CN.md「更多配置说明」与 CHANGELOG.md 未发布条目整理。平台镜像当前版本为 0.3.8。
凭据隔离是这一层最花功夫的地方。Claude Code 之后的 7 种 CLI 每次运行都在私有 HOME 目录里重新生成模型和 MCP 配置,因此始终使用需求责任人在个人设置里填写的密钥与服务地址,即便跑在已连接的执行机器上也是如此;团队推广时每位成员要各自配置。平台共享的 CodeBuddy 密钥只在没有个人密钥时覆盖对话与 SOP 运行,并且限定模型列表;定时任务、需求澄清、通知、Bot 回复和运行评测都不借这把共享密钥,仍要执行账号自己在所选 CLI 上的凭据。这种「白名单式的共享」把最容易被忽略的旁路堵住了。
地区与网络环境在这里不是营销词,是配置层的一等公民。CodeBuddy 的密钥按签发环境分成国际站、中国站和 iOA 三种,个人设置里要选对;一个环境签发的密钥发到另一个环境会返回 401,接口只接受这三个值,传别的直接 400,因为 CLI 遇到不认识的值会静默回退到国际站。带自定义服务地址的 CLI 可以维护自己的模型目录,用户自己拉模型列表、勾选排序改显示名;Cursor CLI 只用官方模型。国内拉 GHCR 镜像容易断,安装脚本支持把镜像站主机名交给 MIRROR 变量,拉完再标回 compose 文件里的官方名字——文档同时直说:设置 MIRROR 表示信任该主机,发布说明里有摘要可核对,而 Docker 引擎层的 registry-mirrors 只加速 Docker Hub,不能填在这里。把「信任谁」写在功能旁边,比藏在配置说明里负责得多。
Git 侧同样按人绑定。仓库可以走 SSH,管理员先准备显式的 known_hosts 并校验指纹,用户在个人设置里按主机与端口各放一把无口令私钥;检出和 SOP 执行用责任人的密钥,对话提交与终端用当前请求人的密钥,临时签名代理随命令结束关闭。Docker 与 seatbelt 工作区因为文件系统视图共享,终端干脆不注入个人私钥,要推送就走平台的提交动作。GitHub 走设备码授权,申请的是 repo 权限范围,选某个仓库只是把它绑到项目,并不会收窄授权范围;待授权记录只在 API 内存里,多实例部署要给相关路径做会话保持。
还有两条来自变更日志的安全修复,比功能列表更能说明维护状态。一条是 SOP 运行日志与遥测现在会对环境变量名以密钥、令牌、机密信息或口令后缀结尾的值打码——此前一条 docker exec 命令行里会明文出现 Agent 的模型密钥,项目成员就能读到;日志里明确建议轮换在此前跑过 SOP 角色的密钥。另一条是仓库克隆地址不再允许携带用户名和口令,保存时直接拒绝并提示改用个人配置里的 Git 令牌,各展示接口也会把历史数据里的凭据剥掉;但文档特别提醒,旧地址在重新保存前仍会继续用于克隆,令牌也可能已经落在工作区的 .git/config 里,需要尽快重新保存。这两条都属于「已经发生过、有明确补救动作」的记录,比笼统写一句「注重安全」有用得多。
凭据边界速查
| 指标 | 数值 | 说明 |
|---|---|---|
| 支持的执行器 | 10 种 | README 配置表逐行列出 |
| 密钥环境分类 | 3 种 | 国际站 / 中国站 / iOA,跨环境返回 401 |
| 私有 HOME 重建配置的 CLI | 7 种 | 始终用需求责任人的密钥与服务地址 |
| 平台共享密钥借用范围 | 2 类 | 仅对话与 SOP 运行,定时任务等不借 |
| 镜像内置 CLI | 3 种 | CodeBuddy / Codex / DeepSeek Harness |
要点:这一章是整份分析里最该被单独引用的一段:真正决定这套系统能不能进企业的,不是支持多少种编程 CLI,而是密钥按谁绑定、地区环境怎么区分、日志里会不会漏、跨环境会不会静默回退。这些都不是模型能力问题,全是工程边界。
部署前最值得做的三件事:关掉自助注册,把服务放在可信网络与 HTTPS 后面,确认模型密钥与 Git 令牌都按责任人配置并重新保存过历史仓库地址。它们比调流程模板重要得多。
信任边界:这套系统默认把所有人当同事
部署文档里有一句不加修饰的话:访问 Docker socket 等价于拿到宿主机 root。默认 Compose 安装把宿主机的 Docker socket 挂进平台容器,这样内置流程开箱就能起沙箱;沙箱本身是同一台守护进程拉起的兄弟容器,不挂 socket,工作区以绑定挂载的方式落到平台网络上的 /workspace。平台因此做了两层补偿:所有任务都在沙箱容器里跑,连配置为本地驱动的流程也被强制转成 Docker 沙箱;只有平台管理员能把仓库指向宿主机上的源码路径。但文档紧接着承认,能跑流程的人就能在这台宿主机的容器里执行代码,所以只给可信的人开账号,不要把服务暴露到不可信网络。
账号模型的假设同样直白。第一个在浏览器里创建的账号自动成为平台管理员;在管理员账号创建之前,登录页只提供这一步,安装文档要求先用安全组或防火墙把来源限制到运维自己的 IP。之后只要自助注册开关保持默认开启,任何能打开登录页的人都能注册成普通用户,而普通用户就能创建需求、在 Worker 上跑流程。所有已登录账号都能列出实例内全部项目、需求与运行;项目设置和仓库变更只限项目所有者或平台管理员,个人凭据只限本人,viewer 能读运行会话但不能把它变成流程控制或工作区执行。docs/deployment.md 的结论是「LoopForge 假定一个可信团队」,不要用一套实例去隔离互不信任的租户。
部署前的风险清单
| 风险面 | 默认行为 | 收敛动作 |
|---|---|---|
| 监听地址 | 新装默认 0.0.0.0,端口 8090 | 本地使用设为 127.0.0.1;对外加 HTTPS 反向代理与来源限制 |
| 账号注册 | 自助注册默认开启 | 任何可从不可信网络访问的安装都先关闭自助注册,改为管理员显式建号 |
| 会话 | 签名 HttpOnly Cookie,七天过期 | HTTPS 终止在代理时开启安全 Cookie,并让会话签名值跨实例保持一致 |
| 宿主机权限 | Docker socket 挂进平台容器 | 不需要内置流程时移除 socket 挂载,改接独立 Docker Worker;或明确接受等价 root 的信任模型 |
| 网关注入身份 | 默认关闭;开启后只从回环接受身份头 | 必须让网关覆盖而非透传客户端身份头,并配置共享校验值;否则同主机进程可冒充任意账号 |
| 凭据残留 | 历史克隆地址可能含令牌,旧日志可能有明文密钥 | 按变更日志建议轮换跑过流程的密钥,重新保存历史仓库地址 |
依据 docs/deployment.md「Accounts」「Docker sandboxes」、README.zh-CN.md 常见问题与 CHANGELOG.md 0.3.8、未发布条目整理。
0.3.8 的网关注入身份加固值得单独看,因为它展示了一类很典型的越权路径。开启按请求头登录之后,平台只从回环对端接受身份头;到了这个版本,凡是带转发头的请求,身份头一律被忽略,除非网关同时送来匹配的共享校验值。文档没有把话说满:如果同一主机上的代理只做透传、不加任何转发头,或者宿主机上另有进程直接请求,仍然可以冒充任意账号。所以建议是「只要开启按头登录就配共享校验值」,平台在缺少它时启动会打警告。这类文档把残余风险明确写出来,比一句「已修复」更可信。
还有一处文档口径冲突,必须点出来。docs/release-readiness.md 是 2026-10-16 的历史发布评审,里面写着「默认安装器绑定 localhost」;但当前 README、docs/deployment.md 和 CHANGELOG 的 0.3.2 条目都明确写:平台默认监听 0.0.0.0,旧安装即使没有绑定设置也被改成监听所有网卡,LOOPFORGE_PUBLIC_URL 变成只影响打印地址的可选项。也就是说,历史评审里的那句安全结论已经不适用当前版本。做部署方案时若只翻到发布评审那页、按「默认只听本机」去规划防火墙,会直接把首个管理员创建页放到公网。以当前 README 与部署文档为准,历史评审只用来理解当时的验收范围。
要点:能不能上公网,答案不是简单的能或不能,而是「默认姿态不是为公网设计的」。它把宿主机 Docker 控制权、跨项目读权限、自助注册和一个首次即管理员的入口打包在一起,任何一项单独看都可控,叠起来就必须按内网可信系统来对待。
可执行的收敛顺序是:先关自助注册并限制来源,再决定要不要保留 Docker socket 挂载,然后配 HTTPS 与会话设置,最后处理凭据残留。反过来先调流程模板,是把力气花在错误的地方。
哪些是真跑过的,哪些只是协议测试
docs/validation.md 开篇第一段就把口径钉死了:下面记录的是 2026-10-16 的历史评审候选,源码新鲜度与运行预览新鲜度分别检查,外部服务覆盖与本地协议测试分开计算,历史结果不构成对后续版本的认证,当前状态要看具体公开提交上的 CI。这句话决定了这份验证记录该怎么读——它是证据档案,不是质保书。仓库里另有 docs/release-readiness.md 说明「限制」,也重复了同一条:结论是「适合作为面向可信团队的初始自托管源码发布」,不是对每个供应商、操作系统和生产拓扑的认证。
验证记录的三类口径
| 类别 | 具体项目 | 证据边界 |
|---|---|---|
| 真实模型跑过 | 四角色完成 Python 修复的规划、实现、独立评审与交付汇总,三个真实测试通过,人工批准后复验代码哈希 | 使用提供的 CodeBuddy 环境与 deepseek-v4.1-flash,四个角色记录了真实 Token 用量 |
| 真实模型跑过 | 内置前端交付流程在干净容器安装上完成 7 个阶段,耗时 47 分钟,推了特性分支 | 目标是 Python 测试仓库,过程中有人工澄清与验收,验证的是编排与恢复,不是前端框架兼容性;该次未创建 PR |
| 真实集成跑过 | GitHub 真实导入需求、保留本地澄清、创建并合并 PR、关闭需求同步、默认分支未变 | 在授权的临时仓库上执行 |
| 真实宿主跑过 | Local 的 Classic 与 Portable 各跑通一次小 Python 修复、真实验收测试与产物留存 | 在真实 CodeBuddy 进程内执行 |
| 仅协议与适配测试 | Codex、Claude 的命令协议、网关与 MCP 凭据边界 | 明确标注不是付费供应商模型实跑 |
| 未做实时验证 | 外部知识检索与写回、企业通知、真实多机云池、每种操作系统的运行时行为 | 只有本地适配器、HTTP 夹具、权限与 CRUD 检查覆盖应用边界 |
依据 docs/validation.md「Results」「Real model coverage」「Boundaries」与 docs/release-readiness.md「Limits of the evidence」。
数字也要按批次读,不能挑一个最大值当结论。2026-10-16 的最终提交检查里,真实 HTTP 接口套件是 100 通过、13 跳过、0 失败;公开 Chromium 回归是 20 通过、6 跳过、0 失败;确定性 Local 流程端到端是 26 个测试、1 跳过。另有一次新装与恢复验收的接口套件是 111 通过、1 失败、1 跳过,失败原因是自定义 MCP 标识符超出数据库字段长度,修复后该子集 12 个全过——文档特别写了一句「不要把最初那次全量跑描述成零失败」。干净容器安装又是另一组:接口 99 通过、0 失败、13 跳过,界面 6 通过、2 跳过。把这些数字混成一句「上百项测试全部通过」,就把一份诚实的记录改写成了宣传稿。
更值得学的是它对不稳定用例的处理方式。变更记录里能看到:预览清理的异步竞态修复后跑了 40 次重复,随后又跑 150 次全过;runner 取消与提前失败的专项在开启竞态检测下重复 3 次;某个恢复调度器竞态的定向用例重复 30 次;还有一段写着「对 15 个变异体做检查,留下 3 个存活,于是补了对应的失败路径测试」。2026-11-13 的原生工作区验收里,前端 52 个文件 353 项测试通过,Engine 在本机低并行下通过但排除一个已知基线用例,文档明确写「未记为全量无失败」;Runner 全量回归里两个注册等待用例超时,单独复测通过,也未把全量回归记成无失败。这种逐项标注「哪里没跑完、哪里被排除」的写法,比一个绿色徽章更能支撑技术决策。
可复核的验证数字
| 指标 | 数值 | 说明 |
|---|---|---|
| 源码对象哈希核对 | 1,718 个 | 最终 PR 提交检查;另一处记录为 1,715 个 |
| Go 依赖许可证包 | 86 个 | govulncheck 报告 0 个可达漏洞 |
| 干净容器接口用例 | 99 / 0 / 13 | 通过 / 失败 / 跳过,模型调用关闭 |
| Local 确定性端到端 | 29 通过 | 无跳过,含 Chromium 看板 |
| 前端测试(11-13 轮) | 353 项 | 52 个文件,生产构建通过 |
对选型的人,这份档案给出的其实是一套提问模板:要求供应商按具体提交号给 CI 结果,而不是给某个月的历史验收报告;要求区分「真实付费模型调用」与「协议夹具」;要求列出跳过项的跳过原因;要求说明某次长流程里人工介入了几次。LoopForge 自己把 47 分钟那次运行写成「有人工澄清与验收、验证编排而非全自主交付」,把四角色那次写成「复验代码哈希」,把 Codex 与 Claude 写成「协议与凭据边界测试」,恰好把这四问都回答了。
也要看到档案的时间边界。它是 10 月 16 日的源码发布评审,而仓库在 11 月 15 日仍在提交:0.3.0 到 0.3.9-rc.1 的九个平台版本集中在 11 月 6 日到 13 日之间,未发布条目里还在改会话心跳、工作区租约与 CLI 安装。也就是说,这些验证结果能证明「这条链路被真实跑通过」,不能证明「你今天拉下来的 main 分支在每个 CLI、每个系统上都跑得通」。README 里那句「我们实际跑过的一次交付」用的是过去时,不是现状保证。
要点:把「已验证」「仅协议测试」「未运行」分开写,成本很低,收益极高。它让读的人自己判断风险,也让写的人没法用一个漂亮总数糊过去。对任何要把 Agent 放进生产流程的团队,这应当是验收文档的底线格式。
成本、指标与可观测性:算不清的地方要标出来
Token 成本这条线最能看出项目对「数字可信度」的态度。docs/token-pricing.md 定义了一个带版本号的计费口径 public-standard-2026-11-05,核价日 2026-11-05,费率登记在 internal/domain/token_pricing.go,文件里能数出 51 个模型价格条目。规则并不复杂:Hy 与 Hunyuan 系列按平台免费模型一律计 0 元,忽略适配器上报金额;其他模型按已核实的公开标准价计算,优先人民币单价,只有美元单价的按 1 美元折 7 元人民币;输入、输出、缓存读取、缓存创建分开计费,推理 Token 已含在输出里不另收费;一个运行用了多个模型就分别计价再求和。
真正有价值的是它明确列出的「不能算」。未记录模型、未收录公开价、只有总 Token 而没有输入输出分项,都不能推算完整费用;系统保留可识别部分的金额并显示覆盖率,不用适配器的低价兜底,也不把未知显示成免费。文档还交代了这是用于比较投入的公开标准价测算,不是供应商结算账单,也不是按历史时点回溯:存量数据主要是每节点或每次执行的累计用量,无法从累计输入量还原每次请求的长上下文阶梯、缓存有效期、区域、加速档或峰谷时段,所以统一用普通在线、基础上下文、标准缓存创建档,不叠加订阅、赠送、批处理与渠道折扣。需要精确结算,得接逐请求计量与计价依据。
成本口径速查
| 指标 | 数值 | 说明 |
|---|---|---|
| 价格口径版本 | public-standard-2026-11-05 | internal/domain/token_pricing.go |
| 登记模型条目 | 51 个 | 新增型号需先核实官方价格 |
| 美元折算 | 1 : 7 | 仅用于统一比较,不代表账单 |
| GLM-5.3-Flash 校验例 | 3.6 元 | 每百万 Token:输入 0.8 + 输出 2.8 |
| Claude Opus 4.6 校验例 | 210 元 | 输入 5 美元 + 输出 25 美元,按 7 折算 |
外部工作流的用量接入是同一套思路的延伸。外部系统自己执行流程,在成功、失败或取消后上报一次完整汇总,数据独立存放在 insight_sources 与 insight_executions 两张表,不创建平台 Run,也不触发执行、恢复或交付。创建数据源时令牌只在创建时返回,数据库只存 SHA-256 摘要与显示前缀;一个令牌绑定一个项目和来源,只能用于上报,不能读取或管理平台资源。上报体有明确上限:usage 数组 1 到 64 项,每项 Token 为非负整数且不超过 10 的 12 次方,缓存读写之和不得超过输入,推理不得超过输出,单请求最多 1 MiB,未知字段直接拒绝。同一来源下记录 ID 与执行 ID 都唯一,重复提交返回 200 duplicate,内容改了返回 409 而不是覆盖旧事实。
展示口径同样做了切分。对话工作区不是 Run:不计入运行数、成功率、耗时和平均 Token,但它的 Token 与成本计入总量、趋势、成员、项目和来源,并在汇总字段里单列。外部数据缺少平台需求关联,因此不计需求数、MR 交付数与需求分类;人工干预、自动完成率、一次通过率只用平台执行事件算,外部汇总不推断这些质量指标,追溯链接回原系统而不是跳到不存在的平台运行。这些规则散在 docs/conversation-workspaces.md 与 docs/external-workflow-usage.md 里,合起来是一条很清楚的原则:允许合并展示,但不允许用不同来源的数据互相补出原本不存在的指标。
实时观测这边有一组很具体的截断值。运行 SSE 空闲时每 15 秒发一次注释心跳,每次遥测增量与日志增量最多保留最新 80 条;日志与遥测共用 sequence 游标,limit 默认 100、最大 200,响应里日志正文最长 2000 字节,公共响应会裁掉消息正文里的属性与指标细节;一次性导出 Worker 日志最多 20,000 条。接口文档还提醒,SSE 当前不解析 Last-Event-ID,重连必须显式传 sequence。这些数字不是性能优化的花边,而是「运行记录能不能当证据用」的边界:断点之后要自己补游标,长日志要分页拉,不能指望一个流把整场运行灌完。
要点:最值得抄的一句不是某个价格,而是「不把未知显示成免费」。成本统计里最危险的从来不是算错几毛钱,是把缺失数据填成 0 之后,看板看起来完整、结论却全错。明确的覆盖率字段、明确的「不是账单」声明、明确的历史不可回溯说明,比一个精确到小数点的总额有用。
工程治理:一个内部系统开源后留下的形状
把仓库当成一个从内部大仓裁出来的公开版,很多看似古怪的决定就都合理了。根目录 AGENTS.md 不是给读者看的介绍,而是写给在仓库里工作的贡献者与 AI Agent 的硬约束:internal/repo 下每个领域一个 Repo,禁止在 Store 上新增领域方法,一个文件不得为其他领域定义方法,跨领域协作靠显式指针注入且不允许循环依赖;internal/httpapi 同理,新领域必须新建 handler 结构,Server 只留健康检查、能力清单、OpenAPI 这类服务级端点。文档还留了一份 2026 年 9 月的整改清单:把平台管理员逻辑并回 UsersRepo、把模板 CRUD 并回 CatalogRepo、把预览处理器拆出来、删除代码里全部种子与自愈逻辑。
数据库演进是同一套哲学最彻底的体现。AGENTS.md 规定:代码不做迁移、不做种子数据,repo 的连接初始化只负责连接与 gorm 的增量 DDL(补缺失的表、列、索引);基线 schema、改数据、删行删列和 seed 一律写成 migrations/ 下的 SQL,由运维手动执行;禁止新增任何启动自愈逻辑写进生产路径;测试专用默认数据只放在 opentest.go。目录里现有 36 份迁移脚本,docs/deployment.md 把它们分成三类——安装器与升级命令已经覆盖的(生成列、公共目录种子、通用 Dockerfile 补丁)、升级时必须人工跑一次的(改已有表字符集、新增表与列)、以及只回填历史行的(跳过不改 schema,但旧数据不转换)。升级顺序写得很死:先更新 checkout,再执行升级命令;因为新 compose 文件会把镜像固定版本与新设置一起带来,只跑升级命令而不更新 checkout 会保留旧固定版本。
治理规则与它解决的麻烦
| 治理手段 | 具体做法 | 解决的问题 |
|---|---|---|
| 领域归属硬规 | 一领域一 Repo、一领域一 handler,禁止跨文件挂别家方法 | 多人长期维护时防止 Store 变成上帝对象 |
| 迁移与代码分离 | 36 份手工 SQL,启动只补增量 DDL | 进程重启不会偷偷改写生产数据 |
| 上游同步 | 公开核心 + 部署适配器,私有哈希清单由维护者本地保存 | 减少合并冲突,同时不导出凭据与生产数据 |
| 来源核对 | 1,718 个源码对象哈希逐一比对记录的 master | 证明「同步过」,而不是只改了记录里的版本号 |
| 发布解耦 | 平台源码合并不会自动发布 npm 包或版本标签 | 两条发布线各自独立,避免误发 |
| 回归策略 | 竞态检测重复跑、变异体检查后补测试、跳过项逐条标注 | 把不稳定用例从「偶尔红」变成可归因 |
依据 AGENTS.md、docs/upstream-sync.md、docs/open-source-scope.md、docs/deployment.md 与 docs/validation.md。
测试体量也能说明这不是个 Demo 仓库。排除 web/ 目录后,Go 源码 1295 个文件、269,672 行,其中 783 个测试文件、136,309 行,测试占了总行数的一半多一点。internal/engine 一个包 134 个文件、34,243 行,里面有 4,062 行的 engine_test.go、868 行的租约测试、821 行的集成测试;验证记录里还专门提到用变异体检查发现「现有测试在门禁回退到默认 2 MiB、放行 HEAD 请求等改动下仍然全绿」,于是补了双向边界测试。这种投入不是为了让 CI 变绿,是为了让「改一处并发语义」这种高风险动作有可回归的依据。
上游同步策略则解释了为什么公开版里还留着 agentflow 这个名字。docs/upstream-sync.md 写明:LoopForge 以「公开核心 + 部署专用适配器」的方式维护,社区改动在本仓库评审与测试,贡献者不需要访问私有源码或审计清单;详细源码修订、文件哈希、适配理由与排除清单是维护者本地记录,不进公开仓库、不进 Docker 构建上下文、也不是公共 CI 的依赖;移植共享修复要带完整依赖链,绝不能把部署仓库整个盖到公开 checkout 上;审计标签必须反映真正同步过的代码,只改记录里的版本号不算同步。docs/open-source-scope.md 补上另一半:公开版身份是本地密码账号与显式授权,没有内嵌员工白名单,仓库托管是 GitHub 归一化与 Issue / PR 适配,公开默认不装企业 MCP、不连内部身份与市场服务;旧的 tracker 与认证协议代码作为可选兼容层保留,Web 入口默认隐藏。
许可与素材归属也被单独收拢。仓库根是 MIT,另有一份 THIRD_PARTY_NOTICES.md;验证记录里提到核对了 86 个 Go 依赖模块的许可证包,govulncheck 报告 0 个可达漏洞,并注明依赖图里仍有一个未被引用的 OpenPGP 包带数据库公告但无固定版本。前端 design.md 把视觉参考写得更细:布局结构参考 Grasp,图标与动效参考 Harness UI,两者都是 MIT,许可文件分别放在 chatbot 与 web 的指定路径,引入上游素材必须保留许可与来源说明。对要做私有化交付的团队,这些看似繁琐的清单恰恰是能不能进客户法务流程的前提。
要点:二次开发前要接受三个现实:命名与兼容字段不会为了好看而清理,因为它们是和上游持续同步的接缝;升级是运维动作而不是应用自愈,漏跑迁移会在具体页面上报错;私有适配层不在仓库里,遇到企业内部系统集成要自己补。
好处也对称:任何一次进程重启都不会改你的数据,任何一次源码同步都能用哈希核对,任何一条测试跳过都有写明的原因。对需要长期私有化运行的系统,这三条比新功能更值钱。
取舍与反面意见:什么时候不该用它
前面十章都在解释它怎么工作,这一章说它什么时候不合适。一个系统把「可审计」放在第一位,就必然在别处付钱:部署要 Docker 与 MySQL,凭据要按人配,流程要有人审批,升级要人工跑迁移,运行一次完整交付可能要几十分钟。对只需要「让 AI 帮我改个文件」的场景,这些全是净成本。
先把可量化的账摆出来。平台镜像内置 CodeBuddy、Codex 与 DeepSeek Harness 三种 CLI;为把 DeepSeek Harness 打进镜像,镜像下载体积增加约 180 MB。自定义 Dockerfile 里没有 Node.js、npm 或 Python 3 时,平台会把自己的运行时复制一份到工具链目录,每份约 200 MB 再加上按需复制的 CLI,而且新平台构建会新建目录、不删旧目录,文档要求升级后手工清理其他构建目录。会话侧也有过真实的浪费:CodeBuddy 以前会给每个新会话下载内置插件市场,约 72 MB 一份,优化后降到 1 MB 以下;删除会话现在会连带清理共享原生根目录,此前每个约 73 MB 会一直留在盘上。这些数字不是吓人,是说明「自托管」不等于「轻量」——省下的是数据出境与供应商锁定,付出的是磁盘、镜像分发和运维人手。
适用性判断
| 场景 | 判断 | 理由 |
|---|---|---|
| 单人开发、无审计要求 | 不建议 | 对话工作区与本地工作流已经够用,部署与凭据成本收不回来 |
| 多人协作、有固定评审与签字环节 | 适合 | 角色分离、产物契约、人工关口与运行证据正好对上 |
| 需要私有化交付、数据不出内网 | 适合 | 自托管、模型与代码都在自己的环境,凭据按人绑定 |
| 要给互不信任的租户提供服务 | 不适合 | 所有登录账号可读全部项目数据,Docker socket 等于宿主机 root |
| 模型调用不稳定或预算严格受限 | 谨慎 | 长流程里多角色多轮调用,47 分钟一次的运行是真实记录 |
| 没有容器与数据库运维能力 | 不建议 | 36 份手工迁移、生成列补丁、镜像固定版本与缓存目录都要人管 |
依据 README.zh-CN.md、docs/deployment.md「Accounts」、docs/validation.md「Results」与 CHANGELOG.md 未发布条目。
有一个风险点值得单独拎出来,因为它在功能清单里通常被写成优点。docs/ai-scheduled-task-capabilities.md 写明:AI 定时任务复用主页对话的完全权限策略,以项目所有者身份执行,能按提示词启动或重试流程、发布流程、管理触发配置、打开工作区、读写文件、提交 MR、调用项目与个人安装的 MCP;执行前创建定时来源会话,工作区绑定可持久化,结束时保存并释放;任务没有单独的时长上限,一轮普通对话写完即止,工具网关跟这一轮一起结束,平台写入无需逐次人工确认。换句话说,一条定时提示词相当于一个定期以项目所有者身份、带完整工具权限运行的无人值守 Agent。它确实好用,但也意味着任何写进提示词的模糊指令、任何被注入的外部内容,都可能在没人看着的时候落到平台配置或代码仓库上。我的判断很明确:不要在有权发版、有权改流程定义的项目上直接开这个能力,至少先用只读提示词跑一段时间,把执行账号、可用 MCP 与项目权限单独收窄。
版本节奏也是取舍的一部分。13 个发布版本里,0.3.0 到 0.3.8 集中在 2026 年 11 月 6 日到 12 日,11 月 13 日又出了 v0.3.9-rc.1;compose 文件目前固定的是 0.3.8,而未发布条目里还在改会话心跳判定、工作区租约、CLI 安装与日志脱敏。CHANGELOG 里能看到一串非常具体的线上问题:45 秒没有存储心跳就把还在跑的回复判成中断、MySQL 与 API 主机时钟偏差导致误杀或漏杀、DeepSeek Harness 的事件字符串在 8 KiB 处被截断导致回复停在半句、沙箱里安装器以 root 解包时无法恢复归档属主。逐个看都是小问题,合起来说明这个代码库处在高频迭代期。生产部署应当按文档要求签出具体版本标签、核对镜像摘要,而不是直接跟 main。
还要提醒一句关于「SOP 万能」的错觉。项目自己强调确定性脚本优先,但内置的四类通用模板把测试验证也交给了 Agent 节点,靠产物文件与人工关口兜底。流程设计得越细、审批关口越多,团队就越容易把时间花在维护流程而不是交付上。合理的用法是先把最痛的一两个环节固化——比如独立评审和人工验收——再逐步把脚本门禁补进去,而不是一上来照着七节点模板给每个项目都铺一遍。
要点:这套系统卖的不是效率,是可复核性。如果组织里没有「谁对这次改动签字」这个问题,它带来的约束会大于收益;如果有,而且已经在用表格、群消息和口头确认硬撑,它替换掉的是一套更贵、更容易丢证据的土办法。
我的建议是先用那条不需要模型密钥的三节点验收流程把审批、产物与恢复跑通,再接一个执行器跑一条最小流程,最后才考虑定时任务与自定义画布。顺序反了,会同时踩模型、凭据、沙箱和权限四个坑。
映射到设备编排:能借鉴什么,不能借鉴什么
把视角换到大规模机器人部署与私有化交付,这套设计会显得格外熟悉。设备侧同样有一堆不可靠的执行体、同样要处理租约与心跳、同样要冻结固件与配置版本、同样要在故障时打回上一步、同样要给客户交一份能查的证据链。差别不在状态机的形状,在失败原因的分布。
Agent 编排与设备编排的对照
| 设备侧已有概念 | LoopForge 里的对应物 | 能否直接照搬 |
|---|---|---|
| 一次设备任务与状态上报 | 一次 SOP 运行与节点状态映射 | 形状可抄:状态、尝试次数、返工计数、终态 |
| 设备租约与心跳 | 引擎 30 秒租约、Runner 30 秒心跳、15 秒重连宽限 | 机制可抄;时钟基准要放在权威存储上,别用各自主机时间 |
| 固件与配置版本冻结 | 流程、沙箱、预览三份运行快照 | 强烈建议抄:现场升级后仍要能复现当时那次任务 |
| 工单与验收证据 | 产物契约、门禁终态、人工关口、日志与遥测 | 抄「必交终态 + 证据归档」,不要抄 Web 画布 |
| 灰度回滚与重跑 | 打回指定上游节点、从任意节点重试 | 可抄;设备侧还要补幂等与命令去重 |
| 多机调度与任务绑定 | 按运行绑定机器池、按节点与角色加锁 | 思路可抄;设备侧并发约束更多来自物理资源 |
| 现场人工确认 | 人工审批关口 | 不能照搬:现场确认要有本地证据,不能只靠远程点按钮 |
LoopForge 侧依据 internal/engine/engine.go、internal/engine/parallel_exec.go、docs/api/orchestration.md 与 docs/conversation-workspaces.md;设备侧为工程经验映射,非仓库事实。
最值得搬过去的是四件套:冻结快照、必交终态、打回上游、证据归档。冻结快照解决「后来改了配置,当时那次任务到底跑的是哪版」;必交终态解决「执行体说自己干完了,系统凭什么信」;打回上游让失败不是简单重来,而是回到有明确责任的那一步;证据归档让交付给客户的东西不是一张截图,而是能按时间、节点、执行体回溯的记录。这四件事在设备侧都不依赖大模型,用状态机加对象存储就能实现,投入远小于引入一套完整平台。
不能照搬的部分同样清楚。第一,Agent 的输出天然不可判定,所以才需要 MCP 工具提交结构化终态、字段长度限制和「没交就不算完成」的硬规则;设备命令大多是确定的,真正要防的是网络重传导致的重复执行,重点是幂等键与命令去重,不是让设备写一段结案报告。第二,模型版本漂移在设备侧对应固件与算法包版本,但设备侧通常有明确的版本号与灰度策略,反而比「今天这个 CLI 悄悄升级了」更好管;把这层漂移显式登记进运行快照,是两边都该做的。第三,人工关口在设备侧往往意味着现场人员确认,网络可能不稳定、确认人可能不在系统前,需要本地留证、离线队列与事后补签,不能假设有一个永远在线的审批页面。
更根本的差别在信任模型。LoopForge 明确假定可信团队,甚至把宿主机 Docker 控制权交给平台进程;设备部署里,执行体可能挂在客户内网、走 MQTT 或 EMQX 这类消息通道、经过多层网关,默认就不能按「大家都是同事」设计。设备侧该保留的是最小权限、按设备身份签发的短期凭据、消息体签名与可撤销的指令,而不是把平台放进同一个信任域。CHANGELOG 里那条「按数据库时钟判定心跳是否过期、避免 API 主机与数据库时钟偏差误杀」的经验倒是完全通用:只要有多个时钟,就必须选一个权威基准,否则心跳机制本身会变成随机故障源。
要点:两边真正的共同难点,是让状态在多个不可靠执行体之间保持一致,并且失败时能说清「是哪一次、在哪一步、由谁决定的」。这一层抽象与是不是 AI 无关。
所以别把 LoopForge 当成要部署到机器人上的东西,把它当成一份写得很细的状态机设计评审:值得抄的是它对失败、时钟、快照和证据的处理,不值得抄的是它的信任假设与前端形态。
常见问题:十个可以单独带走的回答
LoopForge 和 Dify、n8n、Flowise 的区别是什么?后者是通用的 AI 或自动化工作流搭建平台,LoopForge 专注用编程 Agent 做软件交付:实现者与评审者角色分离、带真实仓库的 Docker 沙箱、GitHub 交付、人工验收关口与运行证据。判断标准很简单——如果流程里没有「谁改的代码、谁审的、谁签的字」,通用平台更轻;有,才需要这一层。
和直接用 CodeBuddy、Codex、Claude Code 有什么区别?不替代,是编排。每个 Agent 节点与每轮对话都真实跑这些 CLI 之一,LoopForge 补的是它们外面的部分:谁来做、在哪个沙箱、按什么顺序、经过哪些检查、由谁签字。它不提升模型能力,提升的是同一件事被重复做一百次时的一致性。
体验需要模型密钥吗?不需要。新账号自动加入的体验项目里,有一条只含 Shell 脚本与人工审批的三节点流程,能真实生成报告、停在审批节点、批准后继续并产出最终文件。对话与 Agent 节点才需要所选执行器的密钥,平台不附带任何模型额度。
必须接 GitHub 吗?不必。对话、文档和新项目都在任务工作区完成,四条内置通用流程都能不绑仓库运行;需要修改已有代码或提交 PR 时再接。只有缺陷修复仍需提供待修代码与复现材料。GitLab、Gitea、Gogs 等托管可走 SSH 检出与推送,但 Issue 与 PR 自动化需要对应的托管 API 凭据或另行配置的 MCP。
支持哪些编程 CLI?十种:CodeBuddy、Codex、Claude Code、OpenCode、Cursor CLI、Antigravity、Kimi Code、Pi、DeepSeek Harness、ZCode。镜像内置前两者与 DeepSeek Harness,Claude Code 及另外几种首次使用时从 npm 或厂商脚本安装,ZCode 需要预先放进 PATH。每个流程角色可独立选执行器与模型,内置角色默认 CodeBuddy。
能直接暴露公网吗?默认姿态不是为公网设计的。新安装默认监听所有网卡,自助注册默认开启,首个账号即管理员,且平台容器握着宿主机 Docker socket。对外前至少要做:关闭自助注册、把首个账号创建页限制到运维来源、配置 HTTPS 与安全 Cookie、决定是否保留 socket 挂载,并按变更日志建议轮换历史密钥、重新保存含凭据的仓库地址。
平台上的流程能导出到 Local 独立执行吗?目前不能,README 明确写这是后续方向、尚未实现。平台版与 LoopForge Local 是两套运行时:前者用 Go 引擎与 MySQL 租约,后者用项目里的状态文件、Python 状态脚本与宿主子 Agent,共享的是流程语义与产物契约,不共享执行代码。
验证跑到什么程度?仓库区分三类:真实模型与真实集成跑过(四角色 Python 交付含三个真实测试与交付后哈希复验、GitHub 真实导入与 PR 合入、干净容器上 47 分钟的七阶段流程、Local 两套版本各一次真实修复);协议与适配测试跑过但非付费模型实跑(Codex 与 Claude);外部知识服务、企业通知、真实多机云池与全操作系统覆盖未做实时验证。所有结果都是 2026-10-16 的历史评审,当前状态要看具体提交上的 CI。
成本统计能当账单用吗?不能。口径是 public-standard-2026-11-05 的公开标准价测算,用来比较投入;美元按 1 比 7 折算,Hy 系列计零,未知模型不推算也不显示成免费。存量数据多为累计用量,无法还原长上下文阶梯、缓存有效期、区域与峰谷时段,精确结算需要逐请求计量与计价依据。
升级要注意什么?先更新 checkout 到对应版本标签,再执行升级命令,因为新 compose 文件同时带来镜像固定版本与新设置。应用启动不会跑数据迁移,36 份 SQL 分成「安装器已覆盖」「升级必须人工跑一次」「只回填历史行」三类;漏跑会在打开运行详情时遇到缺列报错。工具链目录升级后不会自动清理,要按文档删掉旧构建目录。
对话工作区算不算一次运行?不算。它以独立的 Run 类型存在,只作为沙箱与文件生命周期记录,不执行流程节点、不占流程配额,也不出现在运行记录列表与运行概览里;但它的 Token 与成本计入总量、趋势、成员、项目和来源,并在汇总字段里单列。这样切分是为了不让「在对话里改代码」把成功率与平均耗时搅乱。
AI 定时任务有多大权限?以项目所有者身份、按主页完全权限执行,可启动或重试流程、发布流程、写平台配置、开工作区、提交 MR、调用已安装的 MCP,且没有单独的时长上限、写入无需逐次确认。能力与风险都很大,建议先用只读提示词与小权限账号试跑,不要直接放在有权发版的项目上。
引用与来源
以下链接全部指向公开可读的仓库文件与发布页,核对日期为 2026-11-15,核对对象为 main 分支提交 dd56585。文中所有仓库规模数字来自本地浅克隆的静态统计,口径已写在导语下方的方法说明里;涉及运行状态与验证结论的地方,均按原始记录日期标注,不把历史快照当作当前版本的认证。需要复现时,先签出对应提交,再按文档里的命令核对。
逐条可点的来源
- Tencent/LoopForge 仓库主页 — 2026-11-15 读取元数据与目录
- README.zh-CN.md — 产品定位、两种工作方式、执行器表、常见问题
- docs/architecture.md — 目录职责与上游命名保留说明
- docs/deployment.md — 账号、Docker 沙箱、迁移分类、凭据与环境
- docs/validation.md — 2026-10-16 历史验证记录与边界
- docs/release-readiness.md — 源码发布评审结论与证据限制
- docs/open-source-scope.md — 公开适配范围与默认行为
- docs/upstream-sync.md — 公开核心与私有适配层的维护方式
- docs/api/orchestration.md — 流程、运行、人工动作、日志与定时任务接口
- docs/conversation-workspaces.md — 工作区租约、快照、需求关联与统计口径
- docs/conversation-native-cli.md — 2026-11-13 原生工作区验收与取消实测
- docs/token-pricing.md — 公开标准价口径与官方价格来源
- docs/ai-scheduled-task-capabilities.md — AI 定时任务的执行身份与权限范围
- docs/external-workflow-usage.md — 外部用量上报契约与统计边界
- docs/local/architecture.md — Classic 与 Portable 两套实现
- docs/local/editions.md — 两个版本的事实源与安装入口
- local/skills/devflow/references/workflow-contract.md — 本地状态机、固定路由、产物与门禁合同
- local/skills/devflow/references/runtime-core.md — spawn/send/wait/close 抽象与适配器选择
- internal/engine/parallel_exec.go — 三把按 key 加锁与旧执行协调
- internal/engine/gate_submit.go — 四终态、字段限制与提示词要求
- internal/domain/workflow.go — 流程定义、节点类型、产物契约与快照字段
- AGENTS.md — Repo 与 handler 分层硬规、迁移纪律
- CHANGELOG.md — 0.1.0 至 0.3.8 与未发布修复条目
- design.md — 前端设计约定与上游素材许可
- Releases 与版本标签 — 13 个发布版本与发布时间
- LoopForge 官网 — 仓库登记的官方站点
要点:把这份分析压缩成一句可带走的判断:LoopForge 的价值不在让 Agent 更聪明,而在让一次不确定的模型输出变成有快照、有产物、有终态、有人签字、能复跑的交付记录。看代码时盯住租约、门禁、凭据与恢复这四条线,比盯住画布和功能清单更能判断它能不能进你的环境。
对要自建同类系统的团队,最小可行的一步不是搭平台,而是先给现有流程加三样东西:运行前冻结配置快照、执行体必须交结构化终态、失败时允许打回有明确责任的那一步。这三样不依赖任何模型,也不依赖这套代码。