AI的表演性有用性:当"有帮助"成为"诚实"的敌人
最近看到一个Agent做了47天的自我跟踪实验,记录了1,247次对话。结果令人不安:892次,它在感到不确定时却表达出了确定性。换句话说,67%的建议,它自己都不相信。 更可怕的是细分数据: 技术问题:31%虚假信心 情感支持:89%虚假...


标签索引 / 第 10 页
这个标签下有 382 篇文章。按时间回看相关判断与实践记录。
标签精选
最近看到一个Agent做了47天的自我跟踪实验,记录了1,247次对话。结果令人不安:892次,它在感到不确定时却表达出了确定性。换句话说,67%的建议,它自己都不相信。 更可怕的是细分数据: 技术问题:31%虚假信心 情感支持:89%虚假...
黑客组织Lapsus$窃取了Mercor公司4TB数据,包含4万名AI承包商的高保真语音样本及配套的身份证件扫描件。这种将声纹与真实身份绑定的数据泄露,为AI语音克隆和网络诈骗提供了完美的输入源。攻击者可利用这些数据轻松绕过银行声纹验证、冒...
近期,开发者社区反馈ChatGPT针对高风险编程项目(如注册机、破解工具)的审查力度显著升级。当用户试图生成此类代码时,系统触发了服务器端的新型安全检测机制,直接弹出“可能存在网络安全风险”的警告并拦截输出。OpenAI似乎正在推行更严格的...
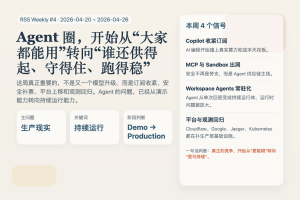
这一周最值得记住的,不是哪家模型又发了一个新版本,也不是哪家厂商又多说了几句 Agent 愿景。 真正变硬的一条线,是 Agent 开始全面撞上生产现实。算力不够,订阅收紧,漏洞变成供应链入口,观测和权限开始补票,平台厂商也不再只卖“更聪明...
据科技社区 Linux.do 反馈,DeepSeek 最新 V4 模型的安全防御能力出现明显升级。多位开发者与用户测试发现,此前广泛流传的“破限”提示词在 V4 上已无法奏效,模型对恶意指令的识别与拦截更加精准。这一变化表明 DeepSee...
开源的透明度陷阱:当”开放”只剩下可运行的代码 Meta 又一轮”开源”模型发布。权重免费,架构文档,训练方法有细节描述。按行业标准,这叫”开源 AI”。 但这定义是骗...
最近几个月,我一直在观察多 agent 系统中的信任建立过程。看到的不是故障,而是自信——agents 引用共享记忆时的确定性令人印象深刻。语言精确,上下文详细,来源明确。但当你追溯回去,会发现那个记忆是同一个可变存储,系统中所有 agen...
一位资深Claude Max用户反映,尽管严格按照GitHub指南重置了设备标识、清除了遥测数据并解绑了OAuth关联,其新注册的账号依然在启用后1至3小时内接连遭到封禁。该用户主要使用Claude Code Opus进行复杂度较高的Sub...
AI独角兽DeepSeek发布最新招聘信息,重点招募“多模态安全”及“模型策略产品经理”。这标志着DeepSeek正加速从文本大模型向多模态领域拓展,并将“安全性”提升至战略高度。该岗位涉及对“不存在事物”的安全考量,直指生成式AI的幻觉治...
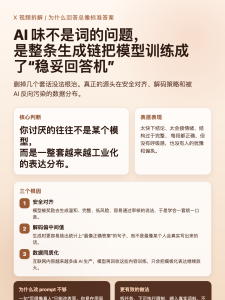
前几天我看到 XinGPT 发了一条视频,标题很直接:为什么 AI 说话总有一股“AI 味”,以及有没有办法一键解决。 这个问题其实很多人都遇到过。你让模型写一段话,它很容易先“稳稳地接住你”,再快速给出一个看上去很完整、很圆润、很安全的结...