跳到主要内容
赞助推荐 搬瓦工怎么选:三网直连 CN2 GIA-E
工程实践 #Pi Agent Core 实战:极简 Agent 运行时从入门到生产

Pi Agent Core 实战(8/10):中断与排队

6 分钟阅读阅读()
#Pi Agent Core 实战:极简 Agent 运行时从入门到生产
赞助推荐 团队协作里的 AI 办公工作台

长任务做到一半,用户发现方向错了。上一代系统的处理方式是等它跑完,或者直接杀进程——前者浪费时间和 token,后者丢掉全部中间结果。循环给了第三种可能:把话插进去,让它下一轮就改。

6 轮工具循环,每轮工具固定 150 毫秒,并在每次 provider 请求前补 25 毫秒模拟网络往返。在第 3 轮开始时入队一条 steering 消息,观察它何时被消费。
赞助推荐 一人公司 · 创业装备库
赞助推荐 一人公司 · 创业装备库

steering 和 followUp 不是一回事

steering 是插话:任务还在跑,你要改变它的方向。它会尽快被消费——在下一个 provider 请求之前被注入上下文。适合「停一下,换个思路」「别扫全量了,先看最近的」。

followUp 是追加:当前任务跑完了,接着做另一件事。它不会打断正在进行的工作,等自然停止之后才被消费。适合「这个查完了,顺手把另一个也看看」。

搞混这两个的后果很直接:该用 steering 的场景用了 followUp,用户的指令要等十几轮之后才生效,体验上等于没听见。反过来,该用 followUp 的用了 steering,正在跑的任务被打断,前面白做。

两种队列的调用方式

// 插话:下一轮生效
agent.steer({ role: 'user', content: '别扫了,直接给结论。', timestamp: Date.now() })

// 追加:当前任务结束后生效
agent.followUp({ role: 'user', content: '之后再查一下磁盘水位。', timestamp: Date.now() })

背景:还有一个队列模式参数:one-at-a-time 是默认,每次只注入一条;all 是把队列里所有消息一次性注入。多人协作或高频插话的场景,one-at-a-time 更可控,不会让模型一下子收到五条互相矛盾的指令。

实测:省 3 轮,快一倍

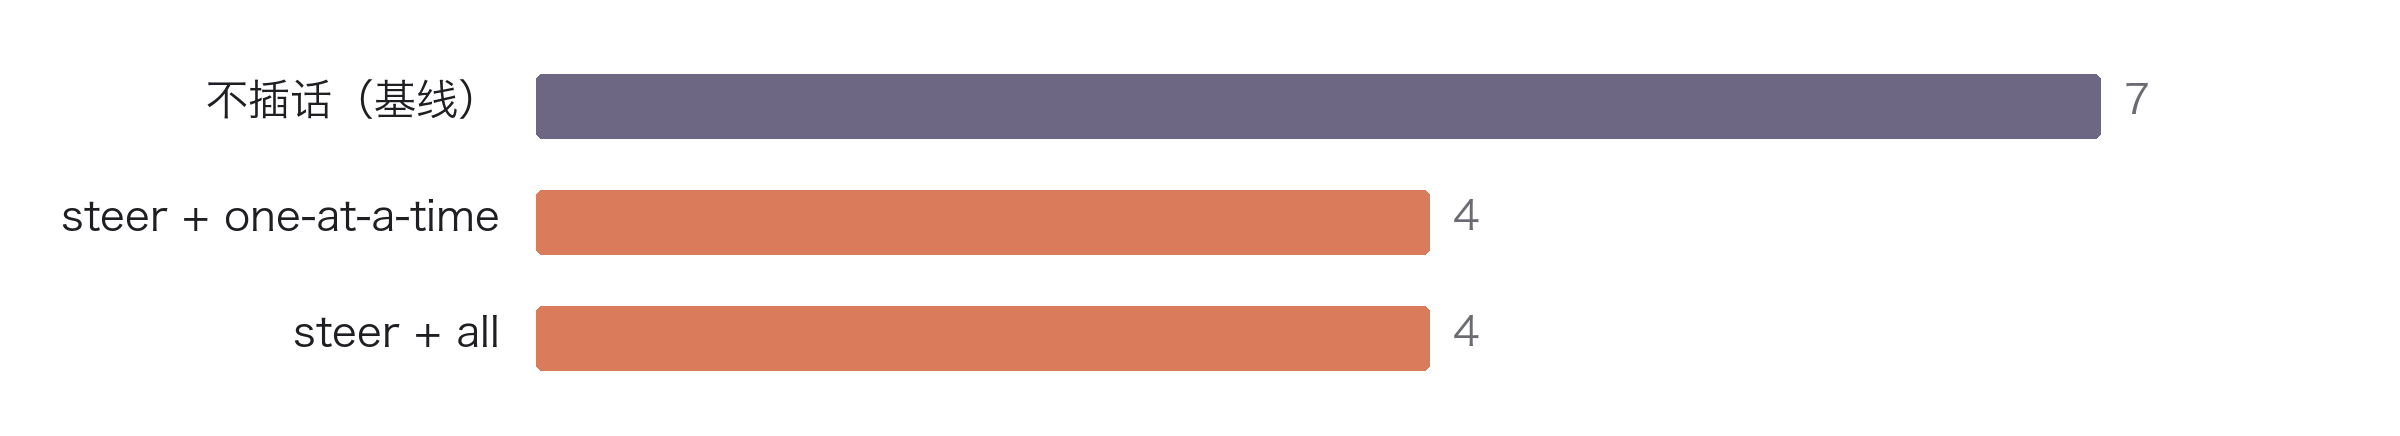
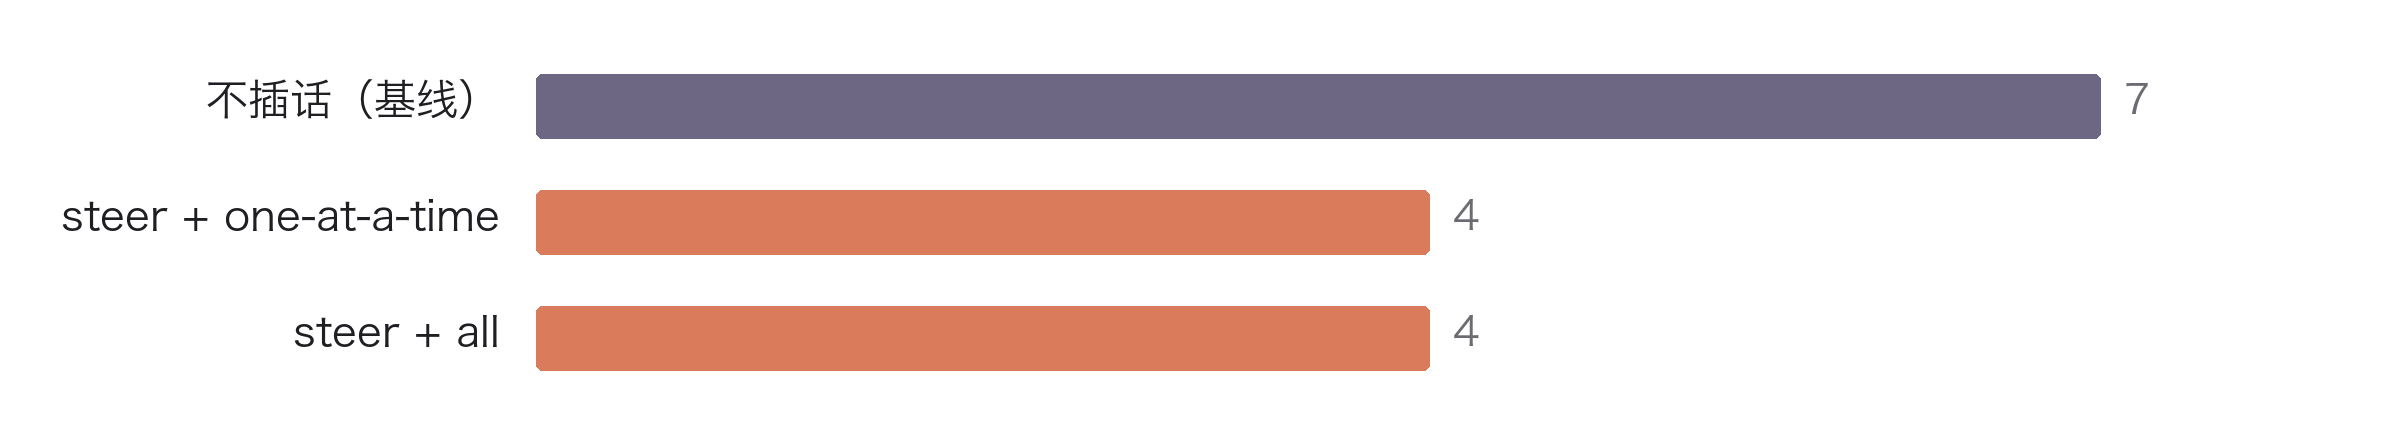
基线跑完 6 个分片需要 7 轮请求(6 次工具加 1 次总结),总耗时 1110 毫秒。第 3 轮插话之后,模型在下一轮就用 3 个分片的已有结果收尾,总轮次降到 4 轮,耗时 571 毫秒。

插话入队到模型真正看到它,间隔 362 毫秒——差不多是当前这一轮工具执行加请求往返的时间。这个延迟是结构性的:插话只能在轮次边界生效,不能打断已经在跑的工具。

所以插话的响应时间取决于单轮长度。如果一轮里有 5 个并行工具、跑 30 秒,插话最坏要等 30 秒。想更快只有一个办法:把长轮拆成短轮。

轮次数对比条形图:不插话 7 轮,steer 单条注入 4 轮,steer 全量注入 4 轮

同一任务三种跑法的轮次数:不插话 7 轮,插话后 4 轮。两种队列模式结果一致,差别只在多条消息的注入粒度。

三种跑法的完整对照

跑法 轮次 扫描分片 总耗时(毫秒) 最终回复
不插话 7 6 1110 6 个分片全部完成
steer 单条 4 3 571 收到,停止扫描
steer 全量 4 3 562 收到,停止扫描

这里有个容易被忽略的设计后果:插话之后模型的行为完全变了,但它并没有“取消”已经跑的工具。第 3 轮那两个工具照常跑完,结果照常进了上下文,模型只是在下一轮决定不再继续。

这意味着steering 是软中断,不是硬取消。真要立刻停下,得用 AbortSignal——那是另一条路径,会丢掉当前轮的产出。选哪个取决于任务能不能白跑。

设计插入点要考虑的事

第一件事是幂等。插话可能在奇怪的位置生效,比如工具刚跑完、结果还没进上下文。你的工具应该允许被重复调用而不产生副作用,否则一次 steering 可能导致重复扣款、重复写库。

第二件事是确认。插话被消费的时候,界面应该给一个明确反馈——「指令已生效」。否则用户不知道自己的话有没有被听见,只能反复发。

第三件事是冲突。如果队列里有两条方向相反的指令,one-at-a-time 模式会先注入第一条,模型执行后可能就不再需要第二条。这通常是对的,但要在界面上让用户看到队列状态,而不是静默丢弃。

第四件事是审计。谁在什么时候插了什么话,必须留在会话记录里。出问题时这是唯一能还原「为什么它突然改主意」的证据。

还有一件反直觉的事:不是所有任务都该允许插话。扫描、迁移、批量修复这类任务,中途改变方向往往意味着前面的工作全废,模型还得重新建立上下文。这种场景更应该做的是把任务切小——跑一个分片就停一次,让人在边界上决定要不要继续,而不是在中间拽方向盘。

判断标准很简单:如果插话之后模型必须回头重做已经做过的部分,那插话就是在制造浪费。这时候真正需要的是更细的任务粒度,不是更强的中断能力。

到这里,循环本身的能力已经讲完。剩下两篇回到工程现场:第 9 篇把脚本编排的死调用改成模型自主决策,第 10 篇讲上线之后的可观测与回归。

引用与来源

赞助推荐 一键部署 AI 大模型
赞助推荐 一键部署 AI 大模型
赞(0)
未经允许不得转载:80aj » Pi Agent Core 实战(8/10):中断与排队
工程实践

Pi Agent Core 实战(8/10):中断与排队

6 分钟阅读阅读()
赞助推荐 团队协作里的 AI 办公工作台

长任务做到一半,用户发现方向错了。上一代系统的处理方式是等它跑完,或者直接杀进程——前者浪费时间和 token,后者丢掉全部中间结果。循环给了第三种可能:把话插进去,让它下一轮就改。

6 轮工具循环,每轮工具固定 150 毫秒,并在每次 provider 请求前补 25 毫秒模拟网络往返。在第 3 轮开始时入队一条 steering 消息,观察它何时被消费。
赞助推荐 一人公司 · 创业装备库
赞助推荐 一人公司 · 创业装备库

steering 和 followUp 不是一回事

steering 是插话:任务还在跑,你要改变它的方向。它会尽快被消费——在下一个 provider 请求之前被注入上下文。适合「停一下,换个思路」「别扫全量了,先看最近的」。

followUp 是追加:当前任务跑完了,接着做另一件事。它不会打断正在进行的工作,等自然停止之后才被消费。适合「这个查完了,顺手把另一个也看看」。

搞混这两个的后果很直接:该用 steering 的场景用了 followUp,用户的指令要等十几轮之后才生效,体验上等于没听见。反过来,该用 followUp 的用了 steering,正在跑的任务被打断,前面白做。

两种队列的调用方式

// 插话:下一轮生效
agent.steer({ role: 'user', content: '别扫了,直接给结论。', timestamp: Date.now() })

// 追加:当前任务结束后生效
agent.followUp({ role: 'user', content: '之后再查一下磁盘水位。', timestamp: Date.now() })

背景:还有一个队列模式参数:one-at-a-time 是默认,每次只注入一条;all 是把队列里所有消息一次性注入。多人协作或高频插话的场景,one-at-a-time 更可控,不会让模型一下子收到五条互相矛盾的指令。

实测:省 3 轮,快一倍

基线跑完 6 个分片需要 7 轮请求(6 次工具加 1 次总结),总耗时 1110 毫秒。第 3 轮插话之后,模型在下一轮就用 3 个分片的已有结果收尾,总轮次降到 4 轮,耗时 571 毫秒。

插话入队到模型真正看到它,间隔 362 毫秒——差不多是当前这一轮工具执行加请求往返的时间。这个延迟是结构性的:插话只能在轮次边界生效,不能打断已经在跑的工具。

所以插话的响应时间取决于单轮长度。如果一轮里有 5 个并行工具、跑 30 秒,插话最坏要等 30 秒。想更快只有一个办法:把长轮拆成短轮。
轮次数对比条形图:不插话 7 轮,steer 单条注入 4 轮,steer 全量注入 4 轮

同一任务三种跑法的轮次数:不插话 7 轮,插话后 4 轮。两种队列模式结果一致,差别只在多条消息的注入粒度。

三种跑法的完整对照

跑法 轮次 扫描分片 总耗时(毫秒) 最终回复
不插话 7 6 1110 6 个分片全部完成
steer 单条 4 3 571 收到,停止扫描
steer 全量 4 3 562 收到,停止扫描

这里有个容易被忽略的设计后果:插话之后模型的行为完全变了,但它并没有“取消”已经跑的工具。第 3 轮那两个工具照常跑完,结果照常进了上下文,模型只是在下一轮决定不再继续。

这意味着steering 是软中断,不是硬取消。真要立刻停下,得用 AbortSignal——那是另一条路径,会丢掉当前轮的产出。选哪个取决于任务能不能白跑。

设计插入点要考虑的事

第一件事是幂等。插话可能在奇怪的位置生效,比如工具刚跑完、结果还没进上下文。你的工具应该允许被重复调用而不产生副作用,否则一次 steering 可能导致重复扣款、重复写库。

第二件事是确认。插话被消费的时候,界面应该给一个明确反馈——「指令已生效」。否则用户不知道自己的话有没有被听见,只能反复发。

第三件事是冲突。如果队列里有两条方向相反的指令,one-at-a-time 模式会先注入第一条,模型执行后可能就不再需要第二条。这通常是对的,但要在界面上让用户看到队列状态,而不是静默丢弃。

第四件事是审计。谁在什么时候插了什么话,必须留在会话记录里。出问题时这是唯一能还原「为什么它突然改主意」的证据。

还有一件反直觉的事:不是所有任务都该允许插话。扫描、迁移、批量修复这类任务,中途改变方向往往意味着前面的工作全废,模型还得重新建立上下文。这种场景更应该做的是把任务切小——跑一个分片就停一次,让人在边界上决定要不要继续,而不是在中间拽方向盘。

判断标准很简单:如果插话之后模型必须回头重做已经做过的部分,那插话就是在制造浪费。这时候真正需要的是更细的任务粒度,不是更强的中断能力。

到这里,循环本身的能力已经讲完。剩下两篇回到工程现场:第 9 篇把脚本编排的死调用改成模型自主决策,第 10 篇讲上线之后的可观测与回归。

引用与来源

赞助推荐 一键部署 AI 大模型
赞助推荐 一键部署 AI 大模型
赞(0)
未经允许不得转载:80aj » Pi Agent Core 实战(8/10):中断与排队
赞助推荐 低成本上手 Claude Code 的中转选择

相关推荐

  • 暂无文章
赞助推荐 一键部署 AI 大模型
赞助推荐 一键部署 AI 大模型