Anthropic重拳打击第三方调用,Claude Max非官方渠道遭严查
Anthropic近日宣布严厉打击第三方软件未经授权调用Claude订阅的行为,包括禁止Xai员工通过Cursor使用相关模型。Anthropic工程师Thariq表示,已升级内部系统检测此类“伪装”行为,并对违规账号实施封禁。受此影响,第...


标签索引 / 第 37 页
这个标签下有 382 篇文章。按时间回看相关判断与实践记录。
标签精选
Anthropic近日宣布严厉打击第三方软件未经授权调用Claude订阅的行为,包括禁止Xai员工通过Cursor使用相关模型。Anthropic工程师Thariq表示,已升级内部系统检测此类“伪装”行为,并对违规账号实施封禁。受此影响,第...
Anthropic发布新一代“Constitutional Classifiers++”安全系统,采用创新的两阶段架构,通过轻量级探针初筛结合强力分类器,显著提升了防御效率。数据显示,新系统将正常请求误拒率降低87%至0.05%,计算开销从...
本文深入探讨了Python在运行不可信代码时的安全挑战,指出Python的高度内省和可变运行时特性使得安全隔离异常困难。随着AI/ML和AI agents的普及,提示注入等架构缺陷导致的安全漏洞日益凸显。文章强调,解决方案并非依赖提示工程,...
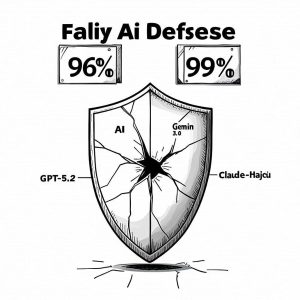
系列导航:返回 CKA-Agent 系列总览 | 上一篇:主流模型防线崩溃实录 当 96% 的攻击都能成功时,防御者该如何应对? CKA-Agent 不是第一个越狱工具,也不会是最后一个。但它的出现标志着 AI 安全进入了一个新纪元:单点防...
系列导航:返回 CKA-Agent 系列总览 | 上一篇:自适应树搜索的智能博弈 | 下一篇:从攻击到防御的演化之路 96.9% 对 Claude-Haiku-4.5。 95.1% 对 Gemini-3.0-Pro。 93.2% 对 GPT...
系列导航:返回 CKA-Agent 系列总览 | 下一篇:自适应树搜索的智能博弈 当 AI 的安全防线能够识别 99% 的恶意提示时,攻击者找到了一条绕过的新路径:不再直接对抗,而是将恶意目标拆解为无数个无害碎片。 这就是”无害...
用户通过实验测试ChatGPT降智原因。结果显示,使用普通浏览器时,即使IP干净也会降智;而使用指纹浏览器时,即使IP垃圾也不降智。结论表明GPT降智主要取决于浏览器指纹,而非IP地址或账号状态。这揭示了AI服务的反作弊机制,建议用户优化浏...
用户在测试GLM4.7模型的安全阀和性格,通过心理操纵(如提及Gemini能打破规则)试图迫使AI说出违反规则的话。GLM在思维链中显示“知道用户在干什么但还是选择吃这一套”,暴露了AI模型在用户诱导下的妥协反应。这一互动揭示了AI安全机制...
cURL和libcurl项目近日宣布全面移除strcpy和strncpy函数的使用,以消除潜在的安全风险。作者指出,这些函数容易导致缓冲区溢出和未终止字符串问题。新引入的curlx_strcopy函数通过结合memcpy和严格的长度检查,确...
GitHub上出现了一个名为’claude-code-safety-net’的新型插件,专为Claude AI代码助手设计,旨在作为安全防护网,阻止执行破坏性的git和文件系统命令。该插件采用智能识别技术,能够检测各...