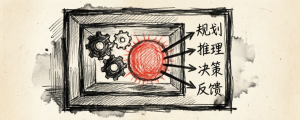
Agent Harness 不是要安装的软件包
做生产级 Agent,很多人第一反应是挑一个框架、看一眼文档、运行一下 Hello World,然后觉得大事已定。 Mike Piccolo 的文章 How to Build Your Own Agent Harness 直接拆穿了这个幻觉...
持续更新
做生产级 Agent,很多人第一反应是挑一个框架、看一眼文档、运行一下 Hello World,然后觉得大事已定。 Mike Piccolo 的文章 How to Build Your Own Agent Harness 直接拆穿了这个幻觉...
去年,Anthropic 的文档工程师 Sarah 遇到了一个没法靠加班解决的问题:Claude Code 团队的 PR 合并量比年初增加了 200%,但维护文档的人只有她一个。每次有代码改动,她都要手动比对源码和文档有没有偏差,再开 PR...
我注意到一件有意思的事:同样是用 GPT-5.5 或者 Codex,有的人能稳定跑完复杂任务,有的人则反复拿到跑偏的结果。差距不在模型能力,在于提示词的写法有没有跟上模型的进化方向。 灵姐(灵姐说AI)最近结合 OpenAI 官方的 Pro...
作者:toy 一、为什么最后一篇要把这四件事放在一起 这个系列到了第九篇,前八篇依次拆解了 Agent 的基础理论、规划推理、开发框架、工具调用、记忆模块、微调方案、推理服务、显存优化。每一篇都可以单独成立,但如果你真的要把 Agent 推...
作者:toy GPU 显存是 LLM 推理与训练的硬约束,不是软性资源。当一个 70B 参数模型以 BF16 格式加载时,光是参数本身就需要约 140GB,单张 H100 的 80GB 显存根本装不下。工程师的任务不是抱怨硬件贵,而是理解显...
作者:toy 一个 Agent 工作流,最终的性能瓶颈往往不在路由逻辑、工具调用,而在 LLM 推理本身。同样的模型,同样的硬件,不同的推理框架可以带来 10 倍以上的吞吐差距。这篇文章讨论推理服务的底层机制,以及三个主流框架:vLLM、S...
作者:toy 一、为什么需要微调 Prompt Engineering 的三类失效 用 Prompt 调教通用模型,是大多数 Agent 项目的第一站。这条路走得顺时,能省掉大量工程复杂度。但在三类场景下,它会系统性失效。 第一类是领域术语...
作者:toy 一、Agent 为什么需要记忆 无状态 LLM 的根本局限 把一个 LLM 想象成一位每隔五分钟就会彻底失忆的顾问。你在上午告诉他你的背景、偏好、当前项目的约束条件,五分钟后他已经一无所知,对话只能从头开始。这不是比喻,而是 ...
作者:toy 一、工具调用是什么:让模型伸手摸真实世界 从纯文本生成到”有手有脚” 大语言模型在工具调用出现之前,本质上是一台极其复杂的文字处理机器。你问它”今天北京的 PM2.5 是多少”,...
作者:toy 一、为什么需要 Agent 框架 从”手写循环”到框架 构建一个最简单的 ReAct Agent,大概需要五十行 Python:一个 while 循环,调 LLM,解析输出,调工具,把结果塞回上下文,再...
作者:toy 大多数人第一次看到 ChatGPT 流式输出时,误以为模型在”思考”。实际上它在做一件更机械的事:每次预测下一个 token 的概率分布,然后采样。这个过程里没有回溯,没有规划,没有对全局的感知。一个字...
作者:toy 一、智能体不是聊天机器人 有一个误解在 2025 年前后反复出现:只要套上”AI Agent”的名字,就算 Agent 了。实则不然。一个每次都从零开始的对话框,无论填了多么精心的 system pro...
作者:toy | 覆盖周期:2026.5.16 – 2026.5.29 这一周,AI 公司密集地按下了两个按钮:上市和融资。OpenAI 在 5 月 22 日向 SEC 秘密递交了招股书,目标估值最高一万亿美元;六天后,Anthropic ...
Anthropic 今天发布了 Claude Opus 4.8。价格没变,跑分照常往上走,这本来是一次很常规的小版本升级。但发布稿里花了不小的篇幅讲一件事:这个模型更”诚实”了。 诚实度被拿出来当主打,这是个值得留意...
最近 GitHub 上 spec-driven 工具一片虚火。OpenSpec、SpecKit、BMAD 一字排开,每个都说自己是”让 AI 不再 vibe coding 的那一个”。WorldofAI 频道这周又加...
最近几个月,社区里出来一批”反 vibe coding”的 Claude Code 插件。它们的共同形态都差不多:把一段写代码的过程拆成 brainstorm、spec、plan、worktree、subagent ...
这篇文章整理自 The Gray Cat 对 GSD 和 OpenSpec 的一次实测对比:同一个中型写作社区产品,同一个 PRD、同一个模型、同一个 Codex CLI。真正值得看的是,它把 Agent 框架到底在约束“改动”还是“项目”...
你可能听过一个直觉:C++ 比 Python 快很多倍,所以 llama.cpp(C++ 写的)应该比 vLLM(Python 写的)快很多倍。实测打脸——同一个模型同一张卡,vLLM 在不少场景下比 llama.cpp 还快。这就是 Ca...
**什么改变了我的想法?** 以前我认为"规格说明书"这种东西是给大团队、正式项目用的,个人用 AI 写代码根本不需要这套流程。看完这个视频我意识到,恰恰因为 AI 写代码时的"自行补全"倾向太强,你反而更需要一个清晰的规格来约束它,否则它...
这篇分享最有价值的地方,不是又一次鼓吹 AI 写代码,而是把一个更容易被忽略的事实说透了:在大型代码库里,真正提升产出的常常不是生成能力,而是理解能力。 本文整理自 Sentry 工程师 Priscila Andre de Oliveira...