图表漂亮、结论清晰,看着完全能交差。直到回头核对原始数据,我才发现有三个数字不是算出来的,是估的。
文中用量数据来自 WorkBuddy 本地 trace(2026-10-01 至 10-31),价格为厂商公开价目;积分折算系数由一次实测反推得到,误差范围已在文内标注。所有数字均可追溯到源文件。
我编了三个数字,还觉得挺合理
报告是给我自己算账用的:这个月在 WorkBuddy 里到底跑了多少 token、值多少钱。做完顺手写了个能复用的东西,本意是下次别再从零排版。
交出去之前我核了一遍原始字段,发现有 三个模型的缓存命中量,是我按比例推出来的。不是算错,是当时手里没这个数、又觉得「按占比估一下应该差不多」。图表看起来完全合理,直到我把原始字段拉出来一行行对,才发现那三个数是编的。
这类失败很隐蔽。编出来的数字不会报错,它会安静地流进图表、流进结论、流进给老板的汇报。等到有人拿它做决策,才发现地基是空的。
注意:真正危险的不是「算错」,是「算得出来」。只要一条链路允许模型在渲染阶段产生数字,它迟早会产生数字。
问题不在我不细心,在流程允许我编数
复盘的时候我发现,问题不在我「不够细心」,而在这条流程允许我算:数据在提示词里,模板在代码里,中间那一步没有任何东西拦着。只要没有拦,迟早会有人——包括我自己——在那儿顺手补一个「差不多」的数。
解法不是反复叮嘱「不要编造」,那是提示词层面的约束,靠自觉。结构性的解法是把一次生成拆成两段职责:事实层负责取数和判定,渲染层只负责排版。
渲染层拿到的输入是一份已经定型的数据文件,里面每个数值都带着出处。它没有网络访问、没有计算逻辑、没有「合理推测」的空间——它只会把 4958 这个数字换算成 PNG 里那根条形的长度,或者写进 Markdown 表格的那一格。它想编也编不出来,因为它不知道数据长什么样,只知道怎么摆。
这个切割带来一个副作用:校验变得可执行。既然文章里的每个数都来自那一份 JSON,那么「文章里的数字是否都能在 JSON 里找到」就成了一条可以自动跑的断言,而不是一次人工复核。
这套切割的实际收益
| 指标 | 数值 | 说明 |
|---|---|---|
| 断言条数 | 30+ | 每次构建自动跑 |
| 产物形态 | 1 个 .md | 走站点既有发布链路 |
| 人工核对 | 0 次 | 数字溯源自动完成 |
顺带解决了另一个老问题:版式漂移。因为排版规则只有一份,今天生成的文章和三个月后生成的文章结构一致,图表的字号、配色、条形比例都固定,不会出现「每次都是新设计」的情况。
一份 JSON 把所有数字关进笼子
skill 的输入不是自然语言,是结构化的内容描述。它描述的是章节与元素,不是像素。目前支持七种元素:段落、指标卡、图表、表格、代码块、提示框、来源清单。
章节顺序、标题、每个元素的位置都由调用方决定;渲染层只管把元素画对。图表支持横向条形和纵向柱形两种,渲染成 PNG 放进 WordPress 媒体库——正文里始终是标准 <img>,不依赖主题对 SVG 的支持。
最小可用的输入片段
{
  "title": "标题,≤60 字符",
  "chapters": [
    {
      "title": "章节标题",
      "sections": [
        { "type": "prose", "paragraphs": ["正文段落"] },
        {
          "type": "chart",
          "heading": "图注标题",
          "caption": "这张图说明了什么",
          "chart": {
            "kind": "bar",
            "unit": "积分",
            "series": [
              { "label": "deepseek", "value": 4958, "tone": "accent" }
            ]
          }
        }
      ]
    }
  ]
}
注意 value 字段。它是这张图唯一的数字来源,图片里条形长度和末端数值都由它算出。换句话说,想让图上出现一个假数字,必须先在 JSON 里写一个假数字——而 JSON 是会被 diff、被复核、被提交进版本库的东西。
拿自己的账本跑一遍
拿手上这份 10 月的实际数据做检验。统计范围是 WorkBuddy 本地 trace 里 7 个模型、142 个会话、2041 次调用,合计 2.89 亿 token。
按客户端里的真实积分倍率折算,全月消耗约 1.02 万积分。这个数字不是从 token 直接换算的:积分 = 倍率 × 用量,而官方没有公开「1.0 倍率对应多少积分/百万 token」这个基准,所以我用一次实测反推——某次 kimi-k3.1-highspeed 会话花了约 2000 积分,用量 419 万 token、倍率 1.56,倒推出系数约 306 积分/(倍率·百万 token)。
各模型积分消耗结构
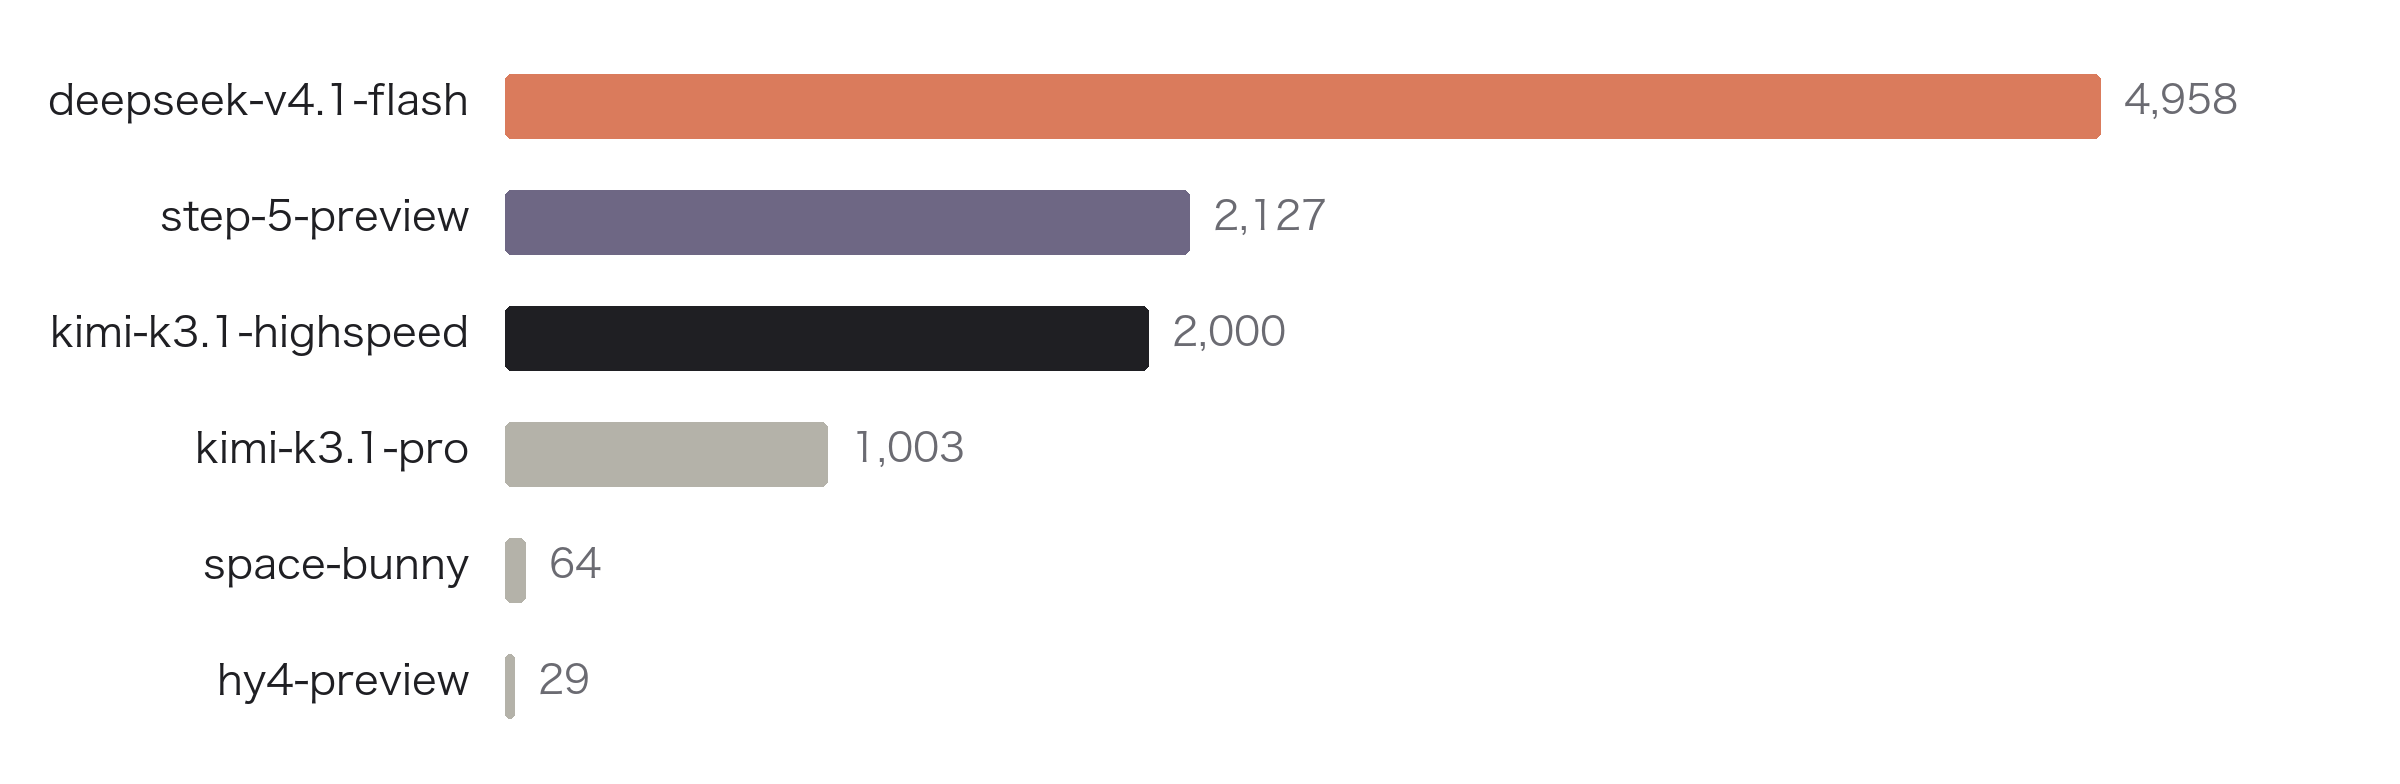
按真实倍率与峰谷折扣折算。deepseek 占 80.8% 的 token,但只占 48.7% 的积分;kimi-k3.1-highspeed 只占 1.4% 的 token,却占 19.6%。
同一批数据,四种口径
| 模型 | token 量 | 倍率 | 积分 | 折人民币 |
|---|---|---|---|---|
| deepseek-v4.1-flash | 233,678,216 | 0.11× | 4,958 | ¥248 |
| step-5-preview | 21,062,006 | 0.33× | 2,127 | ¥106 |
| kimi-k3.1-highspeed | 4,189,465 | 1.56× | 2,000 | ¥100 |
| kimi-k3.1-pro | 3,378,900 | 0.97× | 1,003 | ¥50 |
| space-bunny | 2,633,601 | 0.08× | 64 | ¥3 |
| hy4-preview | 325,508 | 0.29× | 29 | ¥1 |
token 量、积分、人民币、API 直连价是四件不同的事,混着讲就会得出相反结论。
背景:这里有个反直觉的结论:按 API 美元价算,最烧钱的是 gpt-6.1-sol(占 55.8% 成本);换成积分口径,它连倍率都查不到(已不在当前客户端列表),而 deepseek 以 80.8% 的用量占到近半积分。同一份数据换一种计价方式,主角就换人了。
这张图比总账有用得多
总量图表适合汇报,但决策时更有用的是「同一个活换个模型要多少钱」。以那次 kimi 会话的 419 万 token 为基准,把同一个工作量映射到不同档位,差距非常直观。
同等工作量在不同模型下的积分
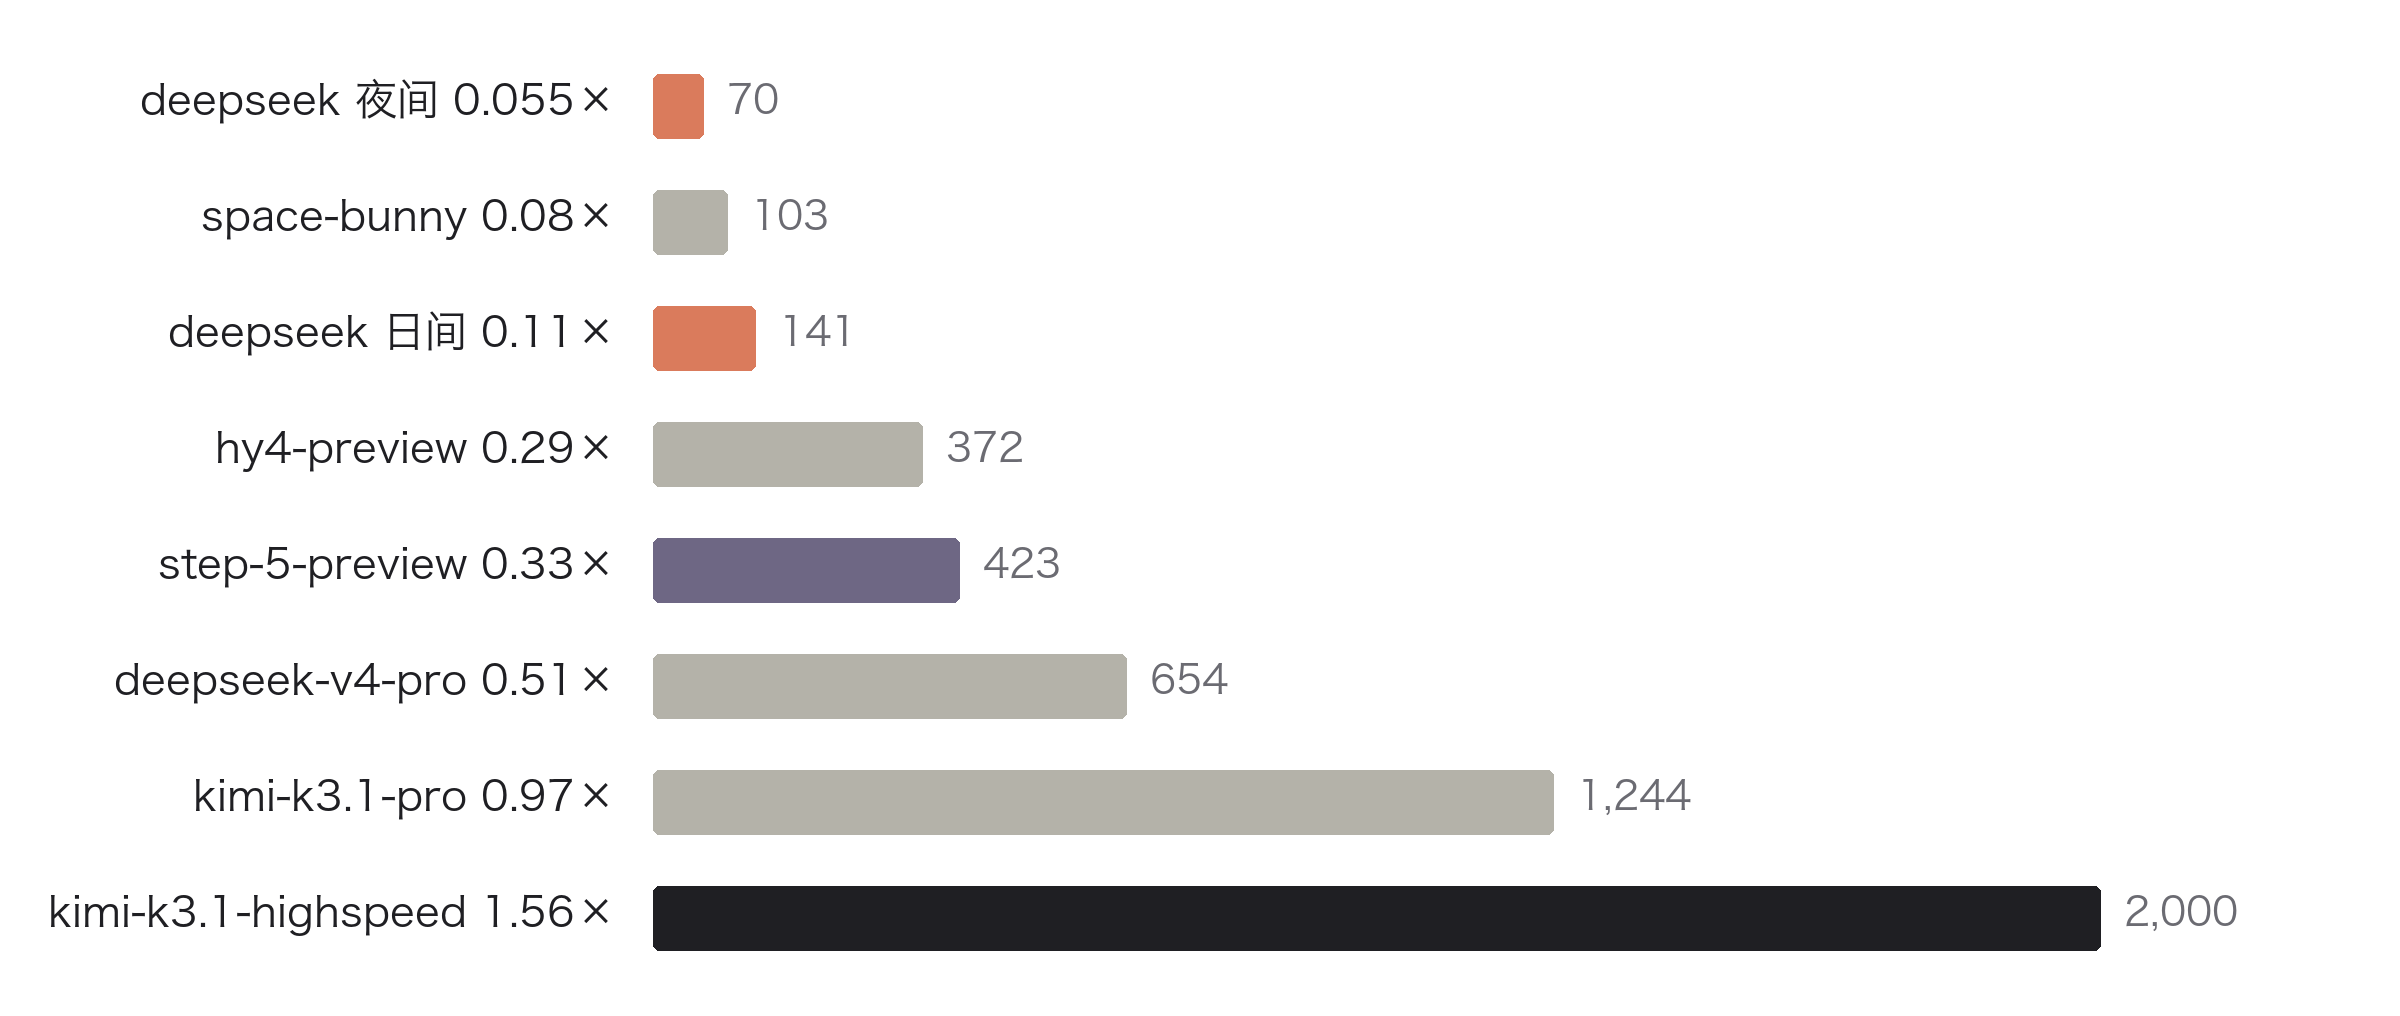
基准为 419 万 token。deepseek 夜间档 70 积分,kimi-k3.1-highspeed 2000 积分,相差 28 倍。这张图直接决定了下次该把活派给谁。
这里要说清楚一个边界:便宜不等于能替代。高倍率模型在长链路、需要一次做对的活上确实有价值,kimi 那次的产出质量也确实够用。这张图回答的是「值不值」,不是「能不能」。把它当成派活时的成本参照,而不是无脑降配的理由。
上线前那 30 道门
渲染完不算完成,必须过一遍断言。这套断言不是按「页面好看」设计的,而是按发布链路的实际契约设计的,分四类:结构、数据、图片、文字。
最容易被忽略的是数据溯源那类。它把 JSON 里每个图表的 value 格式化后,去 Markdown 正文里找;找不到就判失败。这条断言的存在,让「手改正文补一个数字」这种操作立刻暴露。
断言覆盖的四类
结构   首行必须是 # H1(发布脚本靠它取标题)/ 章节数与数据一致
数据   每个图表数值都能在正文里找到;每个来源必须 HTTPS
图片   每个图表都有对应的 PNG 文件与 alt 文本;文件体积在限内
文字   正文 ≥1800 字 / 无 wikilink 残留 / 无套话 / 无凭据字段
这套门不是为了让 AI 少犯错,是为了让错误不可能沉默通过。前者靠模型自觉,后者靠流程。做工程的人都清楚哪个更可靠。
它故意不做的四件事
职责边界写清楚,比功能列表更重要。这个 skill 有四件事刻意不做:
不取数。不连数据库、不读 trace、不调 API。数据由上游准备好,通常是另一个分析任务。这条决定了它没法编造,也决定了它不能独立完成「从零做一份报告」。
不直接发布。它产出 Markdown,发布交给站点既有的 publish 脚本——由那个脚本负责上传封面、设定分类、清三层缓存。渲染和分发分开,出问题时能立刻判断是文章没生成,还是发布失败。
不选题。写什么、角度如何,由调用方决定。skill 不判断内容价值。
不做配图。封面、插图不属于正文渲染。需要图就走单独的生图流程,不要塞进模板。
这个切割有个代价:多了一次数据交接。但换来的是每次构建结果可预期、可复核、可回滚。
三条命令
整个流程四步:准备 content.json,渲染图表,生成 Markdown,过校验。产物是一篇符合站点发布脚本格式要求的 Markdown 文章,连同图片一起交给发布链路。
三条命令
python3 scripts/render_charts.py --data content.json --outdir assets
python3 scripts/build_md.py     --data content.json --out article.md
python3 scripts/verify_md.py    --root .        # 不过就 exit 1

# 产物:article.md + assets/chart-N.png
# 发布:交给站点既有 publish.py(需 WPUSER/WPPASS)
我把它做成 workbuddy 的 skill,是因为这套「取数 → 定型 → 渲染 → 校验」的流程在每次做分析时都会重走一遍。沉淀下来之后,下次只需要关心数据本身对不对,不用再重新决定版式、重新写断言、重新想图表怎么画。
工具的价值不在于替你思考,而在于让已经想清楚的事不必再想第二遍。
数据从哪来
本文所有用量数字来自 WorkBuddy 本地 trace 文件,按 traceId 去重,归日口径为 UTC+8。价格来自厂商公开价目,核对日期标注在下方。积分折算系数由单次实测反推,存在约 ±10% 的抽样误差,请按量级和相对倍数使用,不要当成账单。
引用与核对来源
- DeepSeek API 定价页 — 缓存命中/未命中/输出三档与峰谷时段,核对于 2026-09-18
- OpenAI GPT-6.1 Sol 定价 — 输入 $2 / 输出 $10 / 缓存读取 $0.10,核对于 2026-10-30
- Moonshot Kimi K3.1 Pro 定价 — 标准版与 Highspeed 两档,核对于 2026-10-24
- 阶跃星辰 Step 5 Preview 定价 — 海外档 $1 / $2.70 / 缓存 $0.05