研究 AI 的真实使用边界时,单看“能做什么”不够。更有用的问题是:案例发生在什么场景,使用了哪些步骤,报告对归因和置信度写到了什么程度。


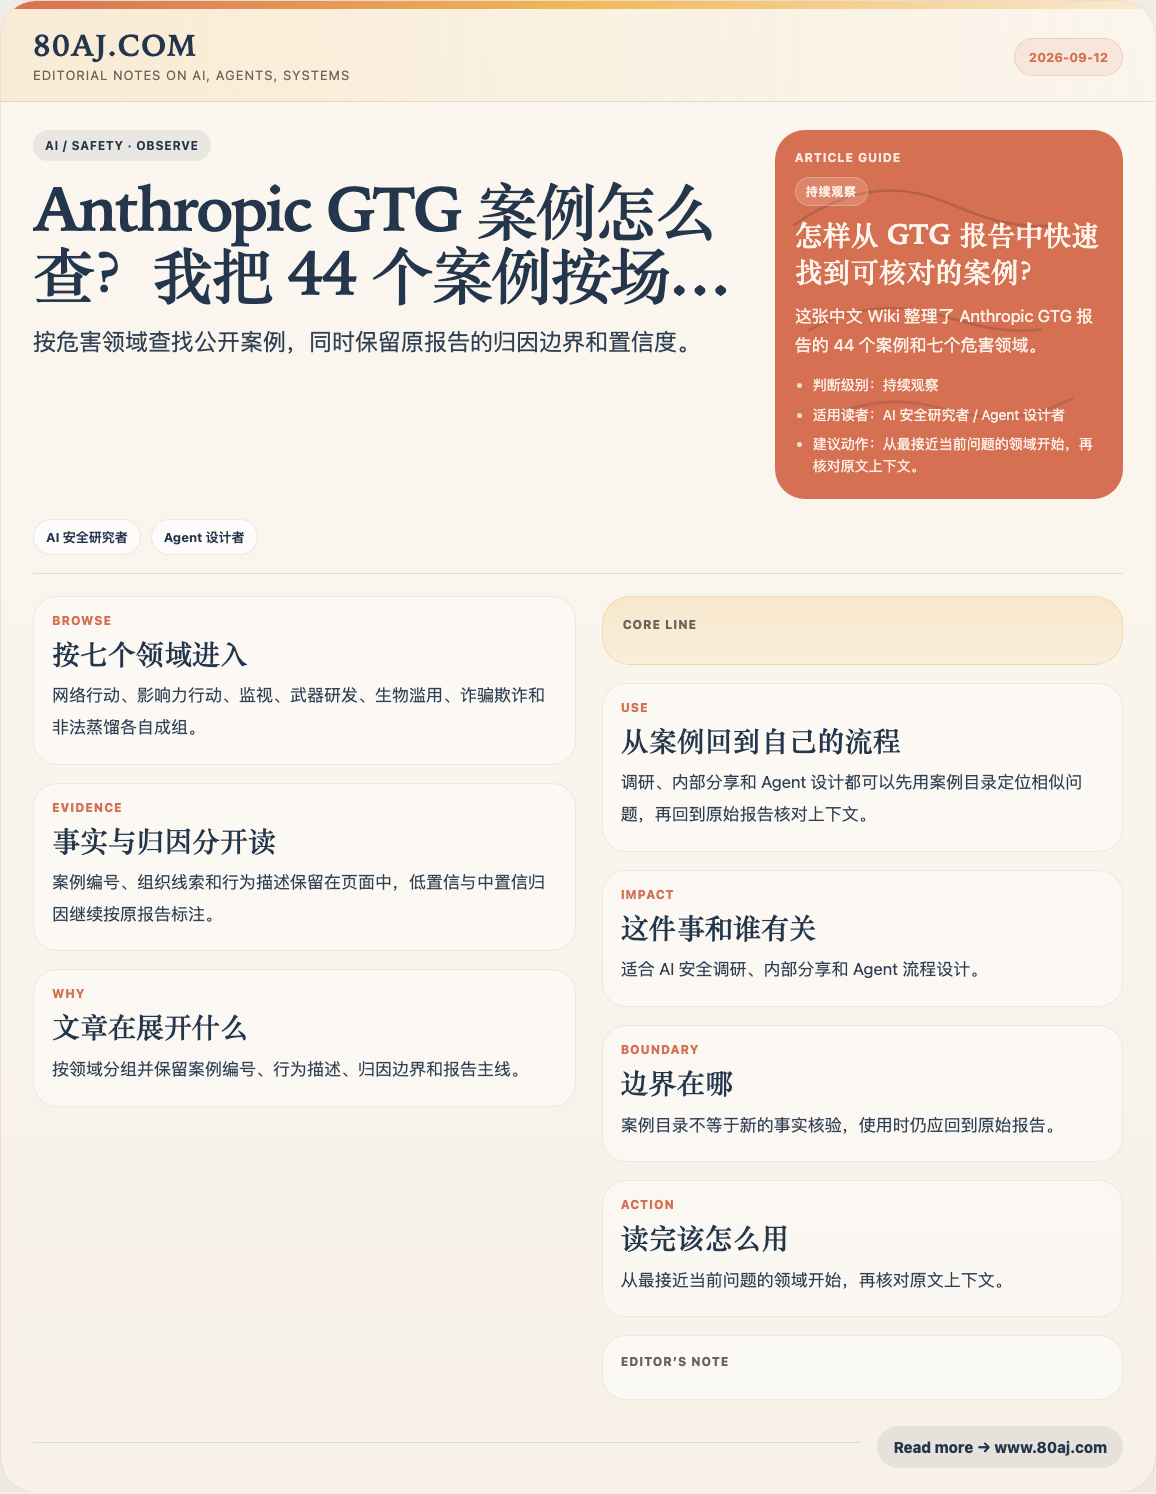
我把 Anthropic《Detecting and Countering Misuse of AI》中的 GTG 案例整理成了中文单页 Wiki: Anthropic GTG 案例中文全览。页面收录 44 个案例,按危害领域分组,适合查资料、准备分享或设计内部 Agent 流程时使用。
先按领域找入口
Wiki 的目录按网络行动、影响力行动、监视、常规武器研发、生物滥用、诈骗与欺诈、非法蒸馏等领域展开。每个领域下面列出案例编号、地点或组织线索,以及报告中的行为描述。
这样的排法适合做横向比较。你可以先看同一领域里的多个案例,再观察 AI 在信息收集、内容生成、自动化执行和规模化运营中的不同作用,不必在长篇报告里凭关键词反复搜索。
页面保留了什么边界
中文整理没有把案例改成“AI 万能模板”。原文中的低置信或中置信归因仍按原有表述保留,案例也没有被改写成产品宣传。读者可以区分报告直接描述的事实、报告给出的归因判断,以及自己对案例的进一步推断。
页面最后还保留报告的两条主线结论,方便读完案例后回看整体判断。准备内部材料时,可以先引用具体案例,再说明证据范围,不要只引用一句抽象结论。
谁会用到这张 Wiki
做 AI 安全研究的人,可以把它当作案例目录;做产品或工程方案的人,可以用它检查一个 Agent 流程可能触及的风险边界;准备分享的人,则可以从一个领域挑案例,再回到原始报告核对上下文。
查看案例: 打开 Anthropic GTG 中文 Wiki