AI转型实战:大模型开发春招突围指南
一位拥有后端基础和实习经验的技术人员,因对后端发展局限和薪资差距的担忧,计划转向大模型开发领域。他寻求学习路径和项目实践建议,以提升春招竞争力。分享了对AI职业转型的思考,讨论了大模型开发的技能需求和行业趋势。 原文链接:Linux.do



标签索引 / 第 195 页
这个标签下有 2417 篇文章。按时间回看相关判断与实践记录。
标签精选
一位拥有后端基础和实习经验的技术人员,因对后端发展局限和薪资差距的担忧,计划转向大模型开发领域。他寻求学习路径和项目实践建议,以提升春招竞争力。分享了对AI职业转型的思考,讨论了大模型开发的技能需求和行业趋势。 原文链接:Linux.do
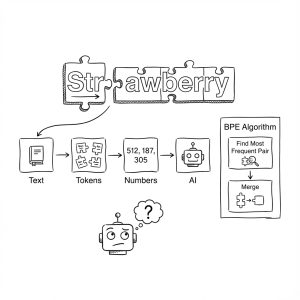
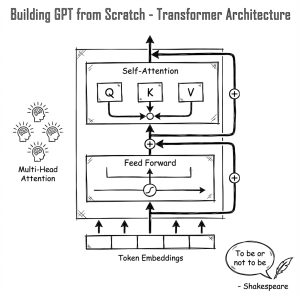
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络07:GPT – 从零实现ChatGPT | → 下一篇:无 这是一个关于大语言模型(LLM)幕后功臣——Tokenizer(分词器)的硬...
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络06:WaveNet – 神经网络大升级 | → 下一篇:Karpathy神经网络08:Tokenizer – 为什么AI不识...
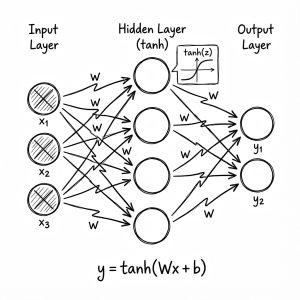
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络02:Makemore – 语言模型入门 | → 下一篇:Karpathy神经网络04:BatchNorm – 解决训练崩盘 ...
TL;DR 开源大模型已经追上闭源——LLaMA 3.1 405B在多项任务上接近GPT-4,Qwen 2.5在中文理解上超越GPT-4o。选模型不是看参数大小,而是看任务适配:LLaMA生态最丰富、Mistral推理最快、Qwen中文最强...
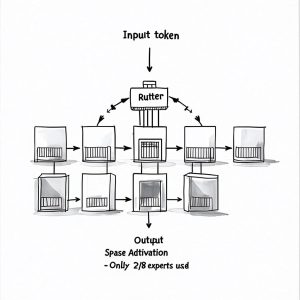
TL;DR 稠密模型的参数规模竞赛已经到头,MoE用稀疏激活让470亿参数的模型跑出130亿的速度;多模态让LLM能看图说话,GPT-4V的视觉编码器是关键;Diffusion模型让AI能画画,DDPM和DDIM是两条技术路线。本文从6个高...
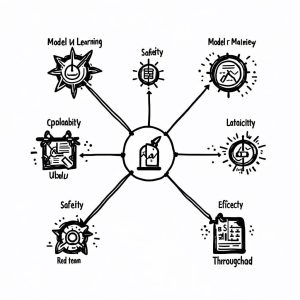
TL;DR 评估和安全是LLM落地的两大关键——不能衡量就无法改进,不能保护就不敢上线。BLEU/ROUGE适合机器翻译但不适合开放生成,困惑度只能评估语言建模能力;幻觉检测用语义熵,偏见测量用CrowS-Pairs;红队测试模拟攻击,差分...
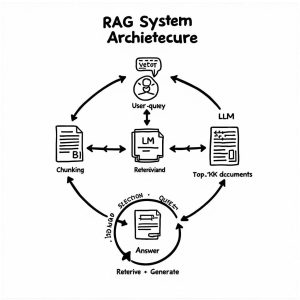
TL;DR LLM的知识有截止日期,RAG让它能查最新资料;LLM只会聊天,Agent让它能干活。RAG的核心是检索+生成,文档分块策略直接影响效果;Agent的核心是感知+规划+记忆+工具,ReAct架构让它能像人一样思考和行动。本文从8...
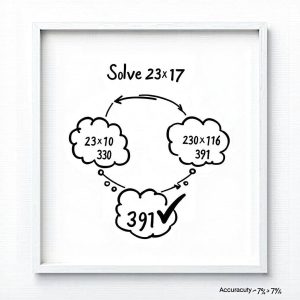
TL;DR Prompt工程是让LLM听懂人话的艺术——同样的问题,换个问法效果天差地别。”让我们一步步思考”这句话为什么能让GPT-4准确率从17%提升到79%?Tree of Thoughts如何让模型像下棋一样...
TL;DR 推理才是大模型的真正战场——训练一次,推理百万次。标准Attention的内存带宽成为瓶颈,Flash Attention通过Tiling技术让速度提升5倍;KV Cache让解码快10倍,但长上下文会吃掉几十GB显存;vLLM...