
Karpathy神经网络08:Tokenizer - 为什么AI不识数
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络07:GPT – 从零实现ChatGPT | → 下一篇:无 这是一个关于大语言模型(LLM)幕后功臣——Tokenizer(分词器)的硬...

本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络07:GPT – 从零实现ChatGPT | → 下一篇:无 这是一个关于大语言模型(LLM)幕后功臣——Tokenizer(分词器)的硬...
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络06:WaveNet – 神经网络大升级 | → 下一篇:Karpathy神经网络08:Tokenizer – 为什么AI不识...
ECS / OSS / CDN / 云数据库一站采购,常用云资源集中选配;新用户与续费均有专场优惠,适合个人开发者与小团队长期使用。
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络05:反向传播 – 徒手写梯度 | → 下一篇:Karpathy神经网络07:GPT – 从零实现ChatGPT 这是Andr...
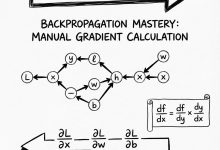
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络04:BatchNorm – 解决训练崩盘 | → 下一篇:Karpathy神经网络06:WaveNet – 神经网络大升级 ...
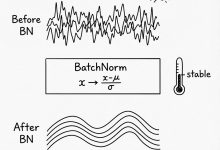
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络03:MLP – 多层感知机 | → 下一篇:Karpathy神经网络05:反向传播 – 徒手写梯度 这是一篇为您准备的关于 ...
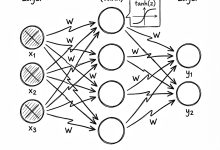
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络02:Makemore – 语言模型入门 | → 下一篇:Karpathy神经网络04:BatchNorm – 解决训练崩盘 ...
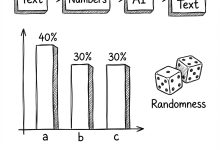
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:Karpathy神经网络01:Micrograd – 手撸一个AI大脑 | → 下一篇:Karpathy神经网络03:MLP – 多层感知机 这是一篇...
本文是《Karpathy神经网络零基础课程》系列文章 ← 上一篇:无 | → 下一篇:Karpathy神经网络02:Makemore – 语言模型入门 这不仅是一个视频总结,更是一堂为你量身定制的 AI 原理启蒙课。 视频的作者...
开发者分享在VSCode的Windows WSL2环境下配置Antigravity插件的失败经历。经过多次尝试,导入后插件无法加载,用户怀疑该插件目前仅适用于Linux系统。帖子引发同行讨论,寻求成功配置经验和解决方案。这反映了跨平台开发工...
Nightshade是芝加哥大学开发的一种创新工具,旨在通过污染图像数据来保护知识产权。它通过在图像中添加人眼不可见的扰动,使这些图像在用于AI模型训练时引入错误,从而阻止模型学习正确内容。该工具有效应对了AI训练中的数据滥用问题,但存在局...
知名技术博主Jeff Geerling宣布将其个人博客从Drupal迁移到Hugo静态站点生成器。自2009年以来,博客一直运行在Drupal上,但作者因维护复杂、升级繁琐而选择迁移。Hugo提供了更简单的Markdown工作流,显著提升了...
本文聚焦于Linux社区中,针对使用kiro和antigravity工具代理Claude AI模型给用户(cc)的技术探讨。多种解决方案被提出,用户核心诉求是寻求最稳定可靠的部署方法。讨论涵盖网络优化、模型性能调校和稳定性保障,为AI模型在...
TL;DR 开源大模型已经追上闭源——LLaMA 3.1 405B在多项任务上接近GPT-4,Qwen 2.5在中文理解上超越GPT-4o。选模型不是看参数大小,而是看任务适配:LLaMA生态最丰富、Mistral推理最快、Qwen中文最强...
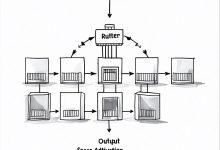
TL;DR 稠密模型的参数规模竞赛已经到头,MoE用稀疏激活让470亿参数的模型跑出130亿的速度;多模态让LLM能看图说话,GPT-4V的视觉编码器是关键;Diffusion模型让AI能画画,DDPM和DDIM是两条技术路线。本文从6个高...
TL;DR 评估和安全是LLM落地的两大关键——不能衡量就无法改进,不能保护就不敢上线。BLEU/ROUGE适合机器翻译但不适合开放生成,困惑度只能评估语言建模能力;幻觉检测用语义熵,偏见测量用CrowS-Pairs;红队测试模拟攻击,差分...
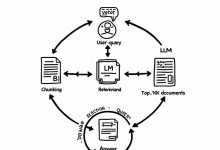
TL;DR LLM的知识有截止日期,RAG让它能查最新资料;LLM只会聊天,Agent让它能干活。RAG的核心是检索+生成,文档分块策略直接影响效果;Agent的核心是感知+规划+记忆+工具,ReAct架构让它能像人一样思考和行动。本文从8...
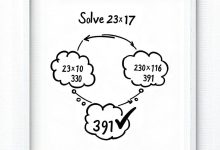
TL;DR Prompt工程是让LLM听懂人话的艺术——同样的问题,换个问法效果天差地别。”让我们一步步思考”这句话为什么能让GPT-4准确率从17%提升到79%?Tree of Thoughts如何让模型像下棋一样...
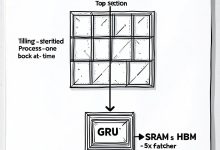
TL;DR 推理才是大模型的真正战场——训练一次,推理百万次。标准Attention的内存带宽成为瓶颈,Flash Attention通过Tiling技术让速度提升5倍;KV Cache让解码快10倍,但长上下文会吃掉几十GB显存;vLLM...
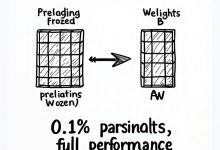
TL;DR 全参数微调一个7B模型要14GB显存,65B模型要130GB——普通人根本玩不起。但LoRA只需要0.1%的参数,QLoRA更狠,单张24GB显卡就能训65B模型。本文从10个高频面试题入手,带你搞懂大模型训练的核心技术:LoR...
TL;DR 面试官问你Transformer原理,你能答到什么深度?本文从12个高频面试题入手,带你搞懂大模型的底层架构——不是背概念,是真正理解为什么GPT用单向注意力、LLaMA为什么选RoPE、多头注意力到底在干什么。读完这篇,你能用...
 Toy